DearMate의 첫 대화 모델을 고르기 위해 같은 대화에 대한 여러 모델의 답변을 비교하는 내부 LLM Arena를 만들었습니다. 답변에 대한 선호와 응답 시간·비용을 함께 살펴보고, 후속 비교를 이어갈 네 후보로 좁혔습니다.
01 · 출발점
1. 첫 모델에서 어떤 문제가 있었나?
팀은 각자가 만들고 싶은 캐릭터의 성격과 말투를 정리하고, 이를 바탕으로 시스템 프롬프트를 만들었습니다. 처음에는 비용과 품질을 함께 고려해 GPT-OSS 계열을 시도했지만, 기대한 대화 품질에 미치지 못한다는 피드백을 받았습니다.
정답 하나로 대화 품질을 판단하기는 어려웠습니다. 같은 위로라도 말투가 어울리는지, 이용자의 상황을 받아 주는지, 다음 말을 건넬 여지가 있는지에 따라 선호가 달랐습니다. 모델을 바꿨을 때 무엇이 나아졌는지 판단하려면, 같은 대화에서 나온 답변을 직접 비교해야 했습니다.
비교에서 확인할 세 가지
- 대화 품질: 같은 캐릭터 설정과 대화에서 어떤 답변을 더 선호하는지 확인해야 했습니다.
- 응답 시간과 비용: 답변을 기다리는 시간과 반복 호출에 드는 비용을 함께 살펴봐야 했습니다.
- 평가 자료: 실제 응답과 사람의 선택을 남겨, 모델이나 프롬프트를 바꿀 때 다시 검토할 수 있어야 했습니다.
02 · 비교 방법
2. 어떤 모델을, 어떤 방식으로 비교했나?
2-1. 후보 모델은 어디서 찾았나?
역할극 대화에 쓸 후보를 찾는 데 LeviTheWeasel/rp-benchmark를 참고했습니다. GPT-OSS에서 출발해 다음 12개 모델로 후보를 넓혔습니다.
- Google: Gemma 4 31B IT · Gemini 3.1 Flash Lite
- Anthropic · DeepSeek · Z.ai: Claude Sonnet 5 · DeepSeek V4 Flash · GLM 5 Turbo
- OpenAI · Meta: GPT-OSS 120B · GPT-5.4 Mini · Llama 4 Maverick
- NVIDIA · Mistral · Qwen · MiniMax: Nemotron 3 Super 120B A12B · Mistral Small 2603 · Qwen 3.6 Flash · MiniMax M2 Her
2-2. 왜 내부용 Arena를 만들었나?
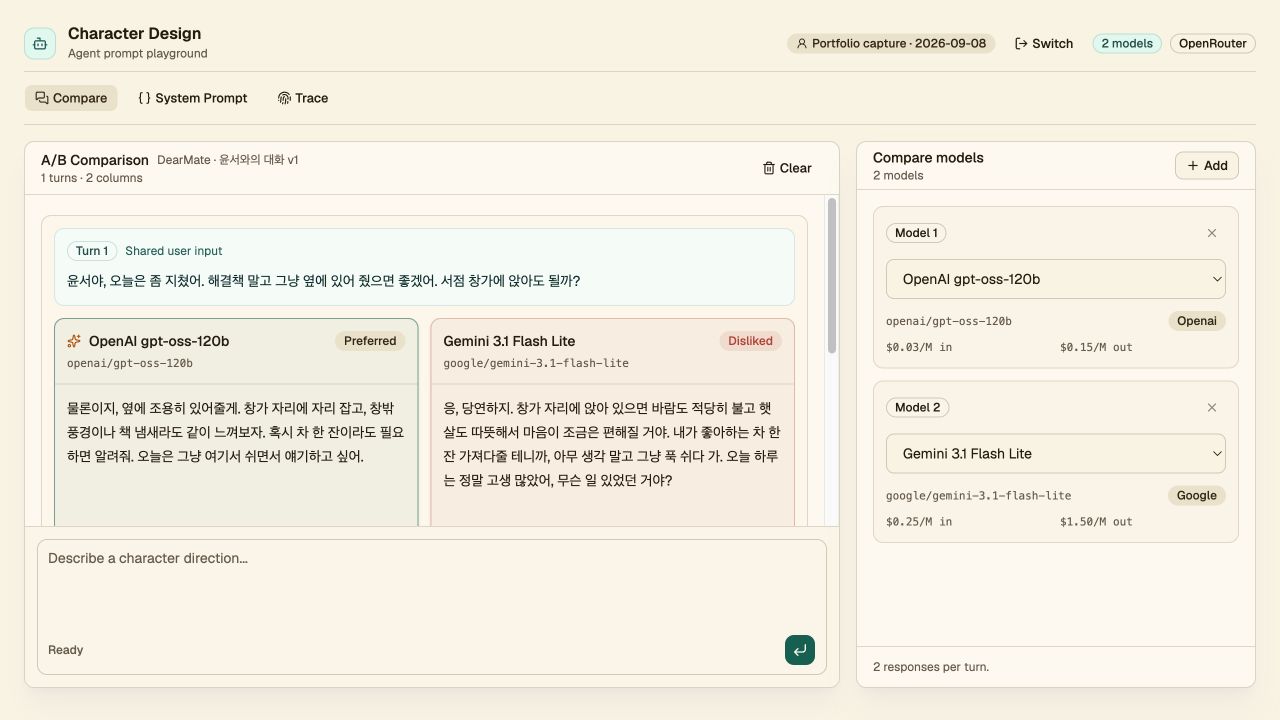
DearMate의 캐릭터 설정과 대화 이력으로 후보를 비교하려면 팀이 직접 쓸 평가 도구가 필요했습니다. 여러 모델의 답변을 사람이 비교하는 Arena 방식을 참고해, 응답과 선호, 평가 조건을 함께 저장하는 내부 평가 플랫폼을 만들었습니다.
2-3. 어떤 조건을 맞춰 비교했나?
한 번의 비교에서는 후보 모델들에 같은 시스템 프롬프트·대화 이력·사용자 입력을 전달했습니다. 생성 설정인 temperature와 최대 출력 토큰도 같은 값으로 요청하고, 후보들을 병렬로 호출했습니다.
평가자는 답변을 읽고 선호·비선호 또는 동률을 남겼습니다. 자연스러움·말투·상황 적합성을 각각 점수로 매기지는 않았습니다.
입력 조건을 맞춘 범위는 한 비교 턴입니다. 실험 전체에서 프롬프트 하나를 고정한 것은 아닙니다. 모델명을 확인할 수 있는 환경이어서 블라인드 평가도 아닙니다.
2-4. 다음 턴에는 누구의 답변을 넣었나?
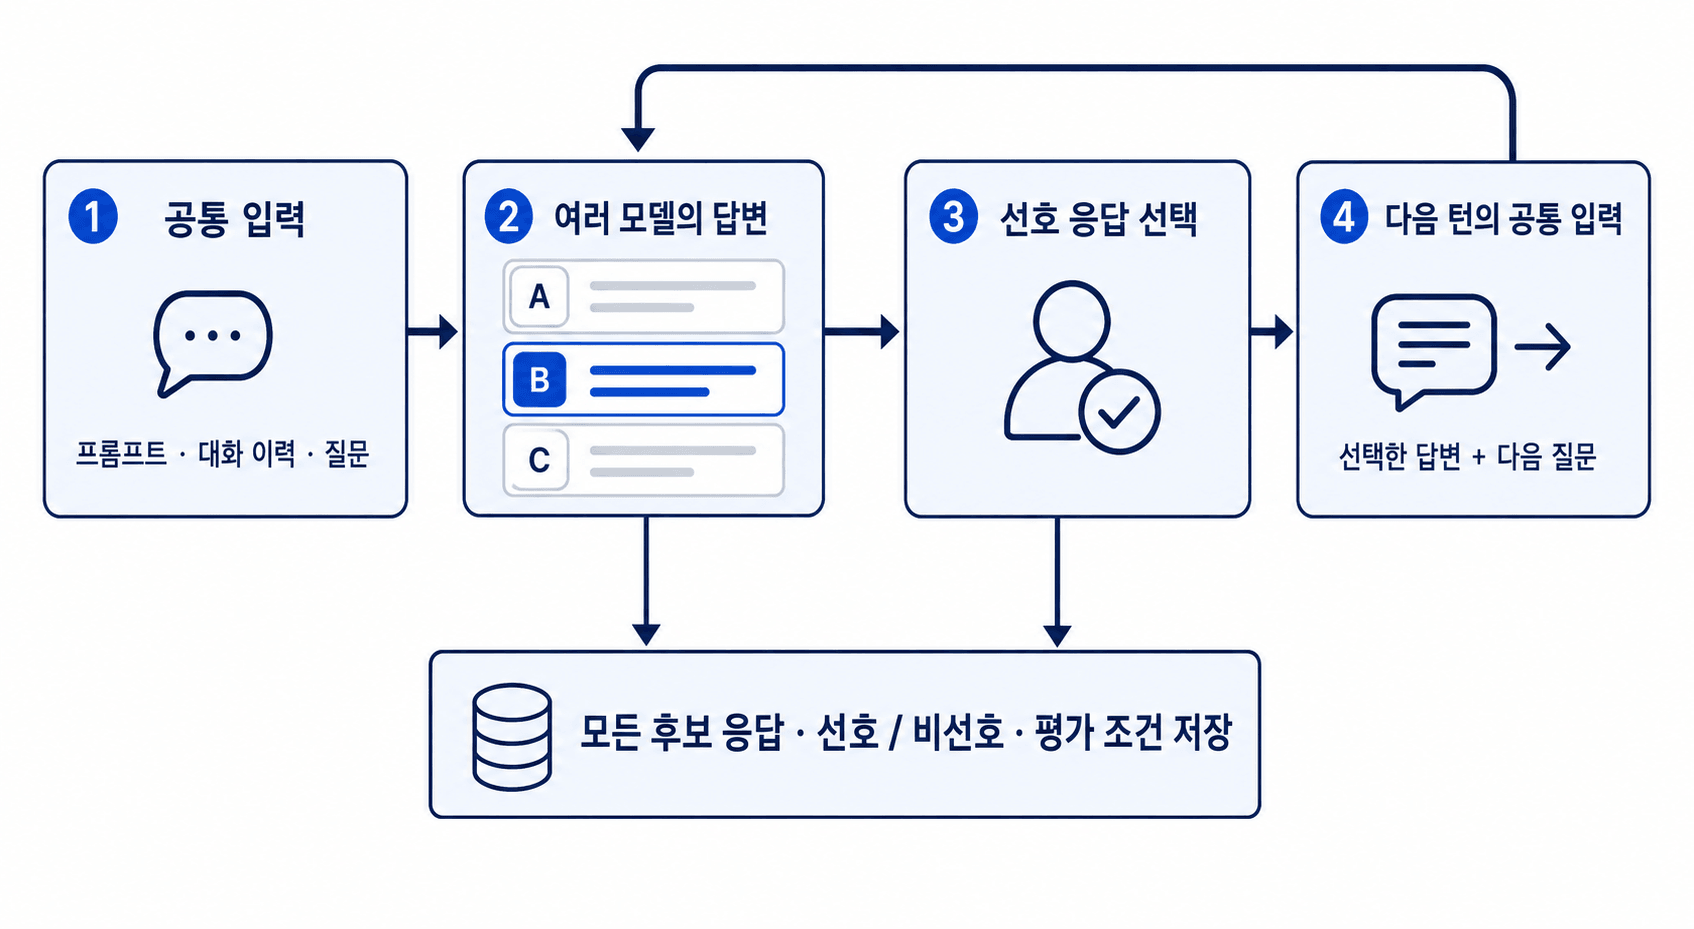
같은 질문에 A·B·C 모델이 답하고, 평가자가 B를 골랐다고 해 보겠습니다. 다음 질문에서는 세 모델 모두에게 B의 답변이 담긴 같은 대화 이력을 전달했습니다. 선택한 답변으로 대화를 이어 가면서 다음 응답도 같은 출발점에서 비교했습니다.
선택하지 않은 A와 C의 답변도 평가 기록에 남겼습니다. 대화에 사용할 답변과 평가를 위해 보관할 답변을 나눠, 대화를 이어 가면서도 모든 후보를 다시 검토할 수 있게 했습니다.
2-5. 선호와 함께 무엇을 기록했나?
나중에 선택 이유와 비교 조건을 되짚을 수 있도록, 선호 평가 이벤트와 평가 시점의 응답별 기록을 연결했습니다.
- 비교 조건: 평가자·대화 턴과 요청/응답 모델을 남겼습니다. 프롬프트 원문·해시, 사용자 발화·맥락 해시로 어떤 입력을 비교했는지 추적했습니다.
- 응답과 선택: 각 후보의 실제 응답과 선호·비선호·동률을 저장했습니다. 선호가 바뀌면 새 평가 이벤트를 추가해 이전 판단도 보존했습니다.
- 시간과 비용: 응답 완료 시간, 성공·실패 상태와 실패 메시지, 입력·출력 토큰을 기록했습니다. 비용은 토큰 사용량과 저장된 모델 단가로 추정했습니다.
03 · 비교 결과
3. 비교 결과는 어땠나?
아래는 당시 기록한 모델별 비교 결과입니다. 초기에 비교를 중단한 후보와 비교를 더 이어간 후보가 함께 있어, 모델별 표본 수가 다릅니다.
선택률은 비교에 등장한 횟수 중 선호로 선택된 비율입니다. 응답 완료 시간은 보통의 기다림을 보는 P50(중앙값)과, 오래 걸리는 응답의 대기 시간을 살펴보는 P95로 나눠 읽었습니다.
| 모델 | 선택률 | 선택/비교 | 성공률 | P50 | P95 |
|---|---|---|---|---|---|
| Gemini 3.1 Flash Lite | 30.5% | 40/131 | 97.7% | 1.26s | 1.88s |
| GLM 5 Turbo | 29.7% | 33/111 | 97.0% | 3.78s | 23.78s |
| Claude Sonnet 5 | 25.8% | 42/163 | 98.1% | 4.51s | 8.56s |
| GPT-OSS 120B | 25.0% | 5/20 | 96.9% | 0.81s | 1.54s |
| DeepSeek V4 Flash | 21.2% | 38/179 | 97.8% | 5.70s | 7.44s |
| Llama 4 Maverick | 17.1% | 7/41 | 100.0% | 1.17s | 1.92s |
| Nemotron 3 Super 120B A12B | 15.0% | 6/40 | 72.1% | 16.99s | 33.73s |
| Mistral Small 2603 | 12.2% | 5/41 | 100.0% | 1.62s | 4.48s |
| Qwen 3.6 Flash | 6.5% | 3/46 | 100.0% | 14.57s | 32.64s |
| MiniMax M2 Her | 0.0% | 0/6 | 100.0% | 8.73s | 9.99s |
| GPT-5.4 Mini | 0.0% | 0/6 | 100.0% | 2.65s | 2.86s |
- 후속 비교는 네 모델로 좁혔습니다. Claude Sonnet 5, DeepSeek V4 Flash, Gemini 3.1 Flash Lite, GLM 5 Turbo를 주요 후보로 정했습니다.
- 선호와 긴 대기 시간을 함께 봤습니다. 이 비교에서 Gemini는 선택률 30.5%·P95 1.88초, GLM은 선택률 29.7%·P95 23.78초였습니다. 선택률은 비슷했지만, 오래 걸리는 응답의 대기 시간에는 큰 차이가 있었습니다.
04 · 선택 기준
4. 이 결과로 어떤 선택을 할 수 있나?
품질·속도·비용을 모두 해결하는 모델은 찾지 못했습니다. 네 후보의 강점이 달라 선택률 하나로 결정을 끝낼 수 없었습니다. 서비스에서 어떤 대화 품질을 우선하고, 어느 정도의 기다림과 비용을 감당할지 기준을 정해야 했습니다.
평가 기록으로는 어떤 대화에서 어떤 답변이 선택됐는지 되짚을 수 있었습니다. 모델이나 프롬프트를 바꿀 때 이전 응답을 다시 읽고, 다음 평가에서 확인할 부분을 찾을 수 있게 됐습니다.
이 기록은 향후 프롬프트 개선과 추가 학습에도 활용할 수 있습니다. 선호 응답은 지시 학습(instruction tuning)의 후보 자료로, 선호·비선호 쌍은 미세조정(fine-tuning)이나 DPO 학습을 위한 자료로 검토할 수 있습니다.
같은 인물로 오래 대화하려면 캐릭터 설정과 기억이 답변에 어떻게 반영되는지도 다뤄야 합니다. 다음 글에서는 가상 인플루언서에게 필요한 구성 요소를 살펴봅니다.