01 · 출발점
LLM이 빨라지면 음성 답변도 바로 들릴까요?
음성 대화에서 사용자는 말을 마친 뒤 답변이 들릴 때까지 기다립니다. 입력 음성을 텍스트로 바꾸는 STT, 답변을 생성하는 LLM, 답변을 음성으로 합성하는 TTS가 차례로 이어지기 때문입니다. LLM의 첫 토큰이 빨리 나와도 인식을 확정하고 발화문을 정리해 음성을 재생하는 시간이 남습니다.
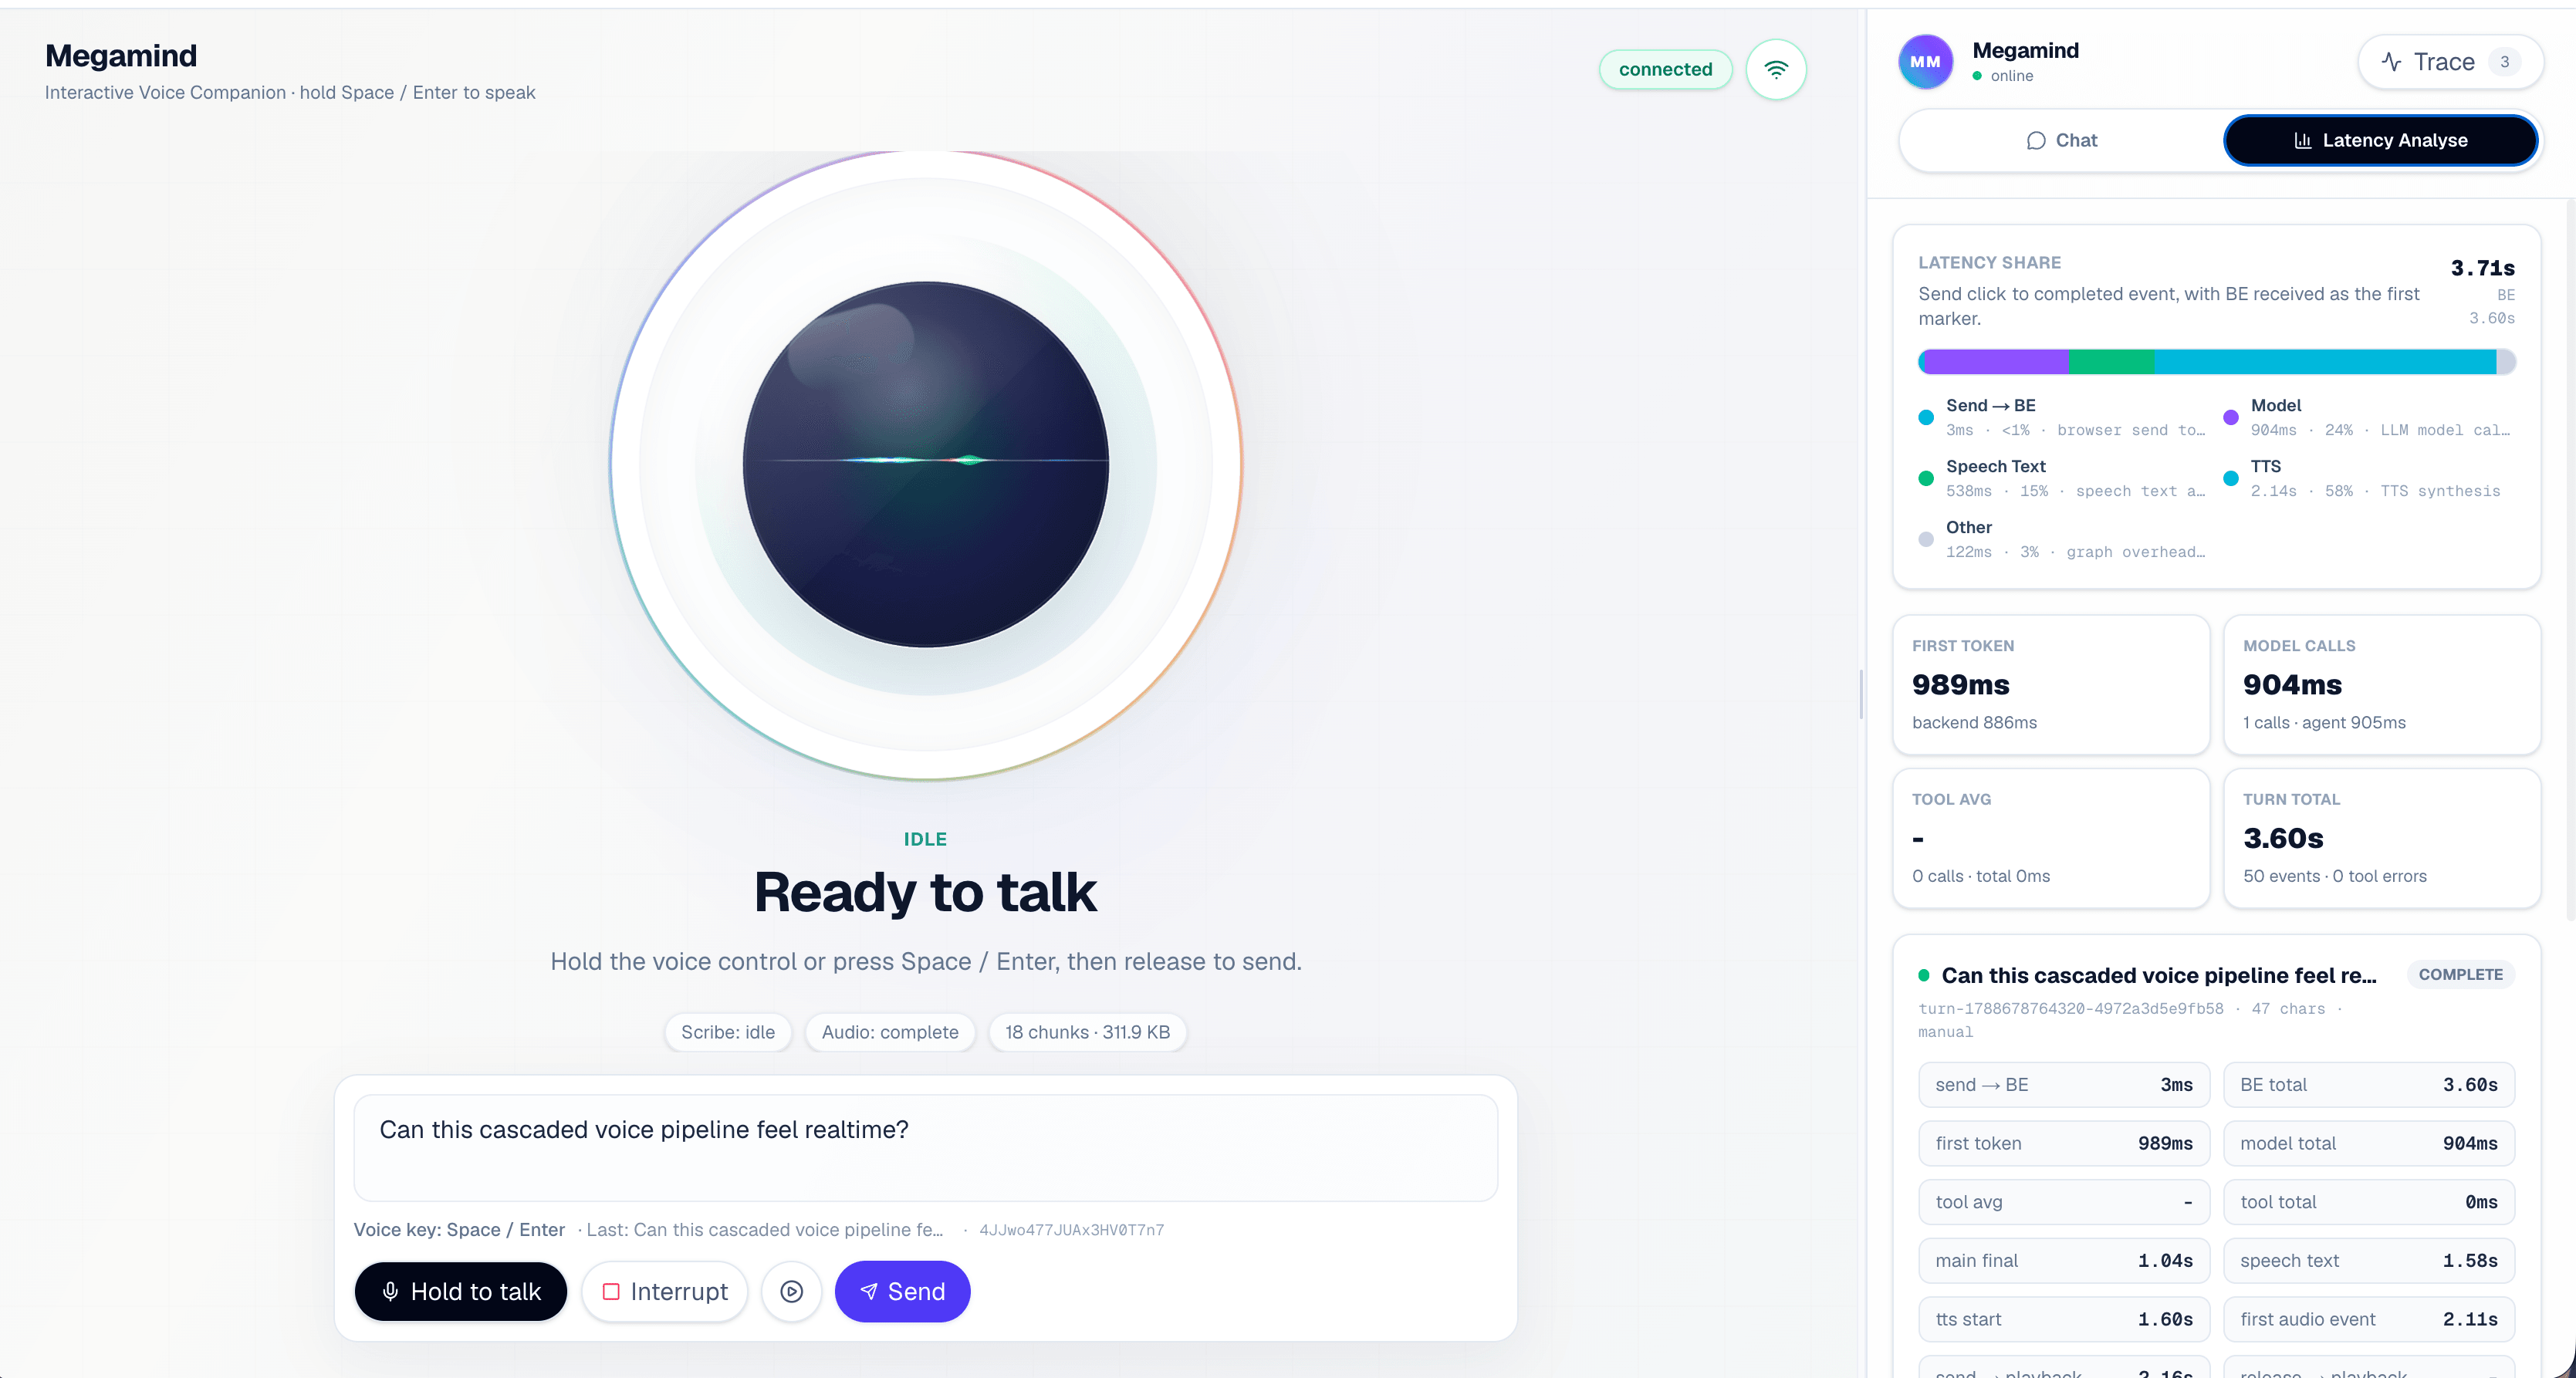
이 프로젝트에서는 Cerebras로 LLM 추론을 가속한 STT → LLM → TTS 조합과 음성을 직접 입출력하는 OpenAI Realtime을 한 화면에 구성했습니다. 빠른 토큰 생성이 실제 대화의 기다림과 비용에 어떻게 이어지는지 살펴보기 위해서입니다. 이 글은 두 경로를 연결한 구조와 입력 종료 처리의 수정을 설명합니다. 측정 기준과 초기 기록은 음성 응답의 지연·비용 실험에서 다룹니다.
02 · 경로 선택
두 경로의 입력과 출력은 어디에서 나뉠까요?
Cerebras 경로에서는 음성 인식, 답변 생성, 발화문 변환과 합성을 각각 조정합니다. OpenAI 경로에서는 하나의 Realtime 세션에 음성을 보내고 음성 응답을 받습니다. 비교의 단위는 이 두 음성 시스템이며, 모델과 음성 처리 방식도 함께 달라집니다.
| 비교 항목 | Cerebras 기반 STT → LLM → TTS | OpenAI Realtime · 음성 네이티브 |
|---|---|---|
| 입력 음성 처리 | ElevenLabs Scribe v2 Realtime · scribe_v2_realtime · 한국어(ko) | gpt-realtime에 음성 입력 · 별도 STT 단계로 분해하지 않음 |
| 응답 생성 | Cerebras 직접 호출 · gpt-oss-120b | OpenAI gpt-realtime |
| 발화문·음성 생성 | Speech Text Agent: gpt-oss-120b · TTS: ElevenLabs Flash v2.5 · eleven_flash_v2_5 | 동일 Realtime 세션에서 음성 출력 · 기본 voice: marin |
| 실행 구조 | LangChain + LangGraph · Main → Speech Text → TTS | 브라우저 음성 연결 + 같은 세션의 서버 관측 |
| 외부 도구 | 비교 모드 tools=[] · 일반 경로는 전용 키 설정 시 Firecrawl 등록 | 현재 비교 세션 tools=[] |
| 연결·관측 | STT·TTS 스트리밍과 브라우저 출력 계측 | 음성 전달과 응답 이벤트·사용량 계측 |
현재 비교 경로의 구성입니다. 동일 대본을 사용한 통제 비교는 후속 실험 계획입니다. 버튼을 놓아 입력을 끝내는 PTT와 침묵으로 종료를 정하는 VAD는 측정 시작점이 다릅니다.
텍스트를 경계로 연결한 Cerebras 경로
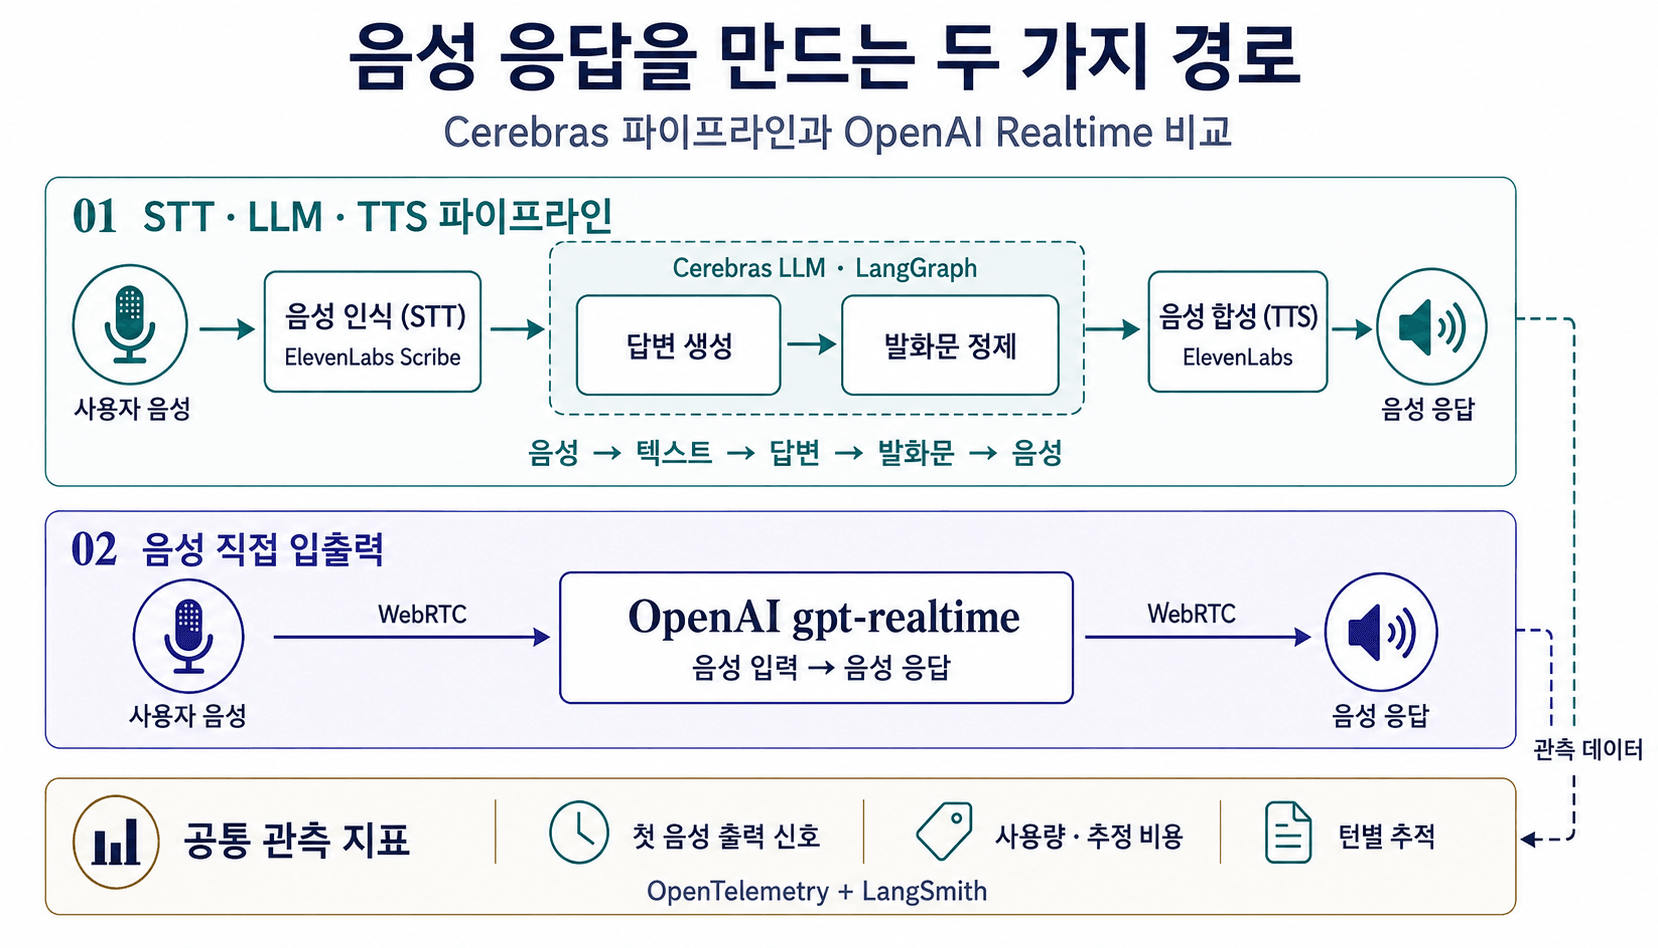
브라우저에서 받은 음성은 ElevenLabs Scribe가 텍스트로 바꿉니다. 확정된 질문을 받은 Main Agent는 화면용 답변을 만들고, Speech Text Agent는 그 답변을 말하기 좋은 문장으로 바꿉니다. 두 단계 모두 Cerebras의 gpt-oss-120b를 직접 호출합니다. LangGraph는 이 순서를 연결하고, 마지막 단계에서 ElevenLabs TTS가 만든 오디오 청크를 브라우저로 전달합니다.
TTS는 LLM이 필요할 때 고르는 도구가 아니라 발화문 다음에 실행하는 합성 단계입니다. 화면에는 Main의 답변을 보여 주고, 재생에는 별도로 만든 발화문을 사용합니다. 따라서 화면 출력의 형식을 바꾸는 일과 음성 표현을 조정하는 일을 나눌 수 있습니다.
음성 전달과 관측을 나눈 Realtime 경로
OpenAI gpt-realtime은 브라우저와 실시간 미디어를 주고받는 WebRTC로 연결합니다. 백엔드는 같은 세션에 별도의 WebSocket 연결인 sideband를 열어 응답 이벤트와 사용량을 받습니다. WebSocket은 연결을 유지하며 메시지를 주고받는 방식으로, Cerebras 경로의 Scribe 입력과 서버 스트리밍에도 사용합니다.
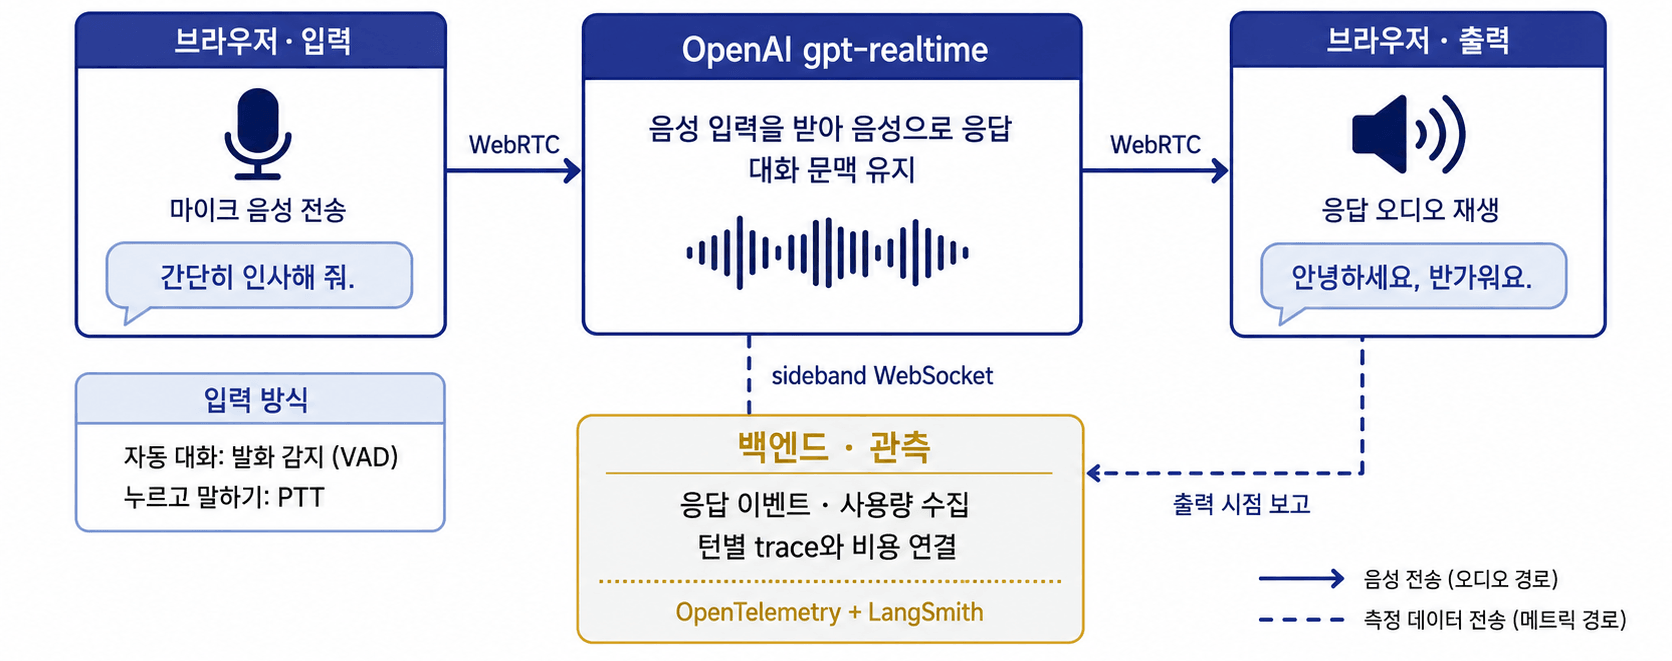
입력을 끝내는 방식은 연결 방식과 별도로 선택합니다. PTT(Push-to-Talk)는 버튼을 눌러 말하고 놓을 때 입력을 끝냅니다. VAD(Voice Activity Detection)는 발화와 침묵을 감지해 종료를 정합니다. Cerebras는 PTT를 사용하며, OpenAI는 기본 자동 대화인 VAD와 연결 전에 선택하는 PTT를 지원합니다. OpenAI의 두 모드는 같은 WebRTC 연결을 사용합니다.
현재 비교 모드에서는 양쪽 도구 목록을 tools=[]로 비웁니다. 일반 Cerebras 경로에는 전용 키가 있을 때 Firecrawl 검색 도구를 등록하는 설정이 있지만, 비교 전용 경로와는 구분됩니다. 공통 도구를 붙여 비교하는 실험은 후속 시나리오에 두었습니다.
03 · 출력의 책임
화면 답변을 그대로 읽으면 무엇이 달라질까요?
화면에서는 표의 행과 열, 목록의 순서, 마크다운 서식을 눈으로 구분할 수 있습니다. 같은 문자열을 TTS에 보내면 기호가 발화에 섞이거나 항목 사이의 관계를 듣기 어려워집니다. 반대로 Main의 모든 답변을 짧은 구어체로 제한하면 상세한 설명과 구조화된 화면 출력도 제약받습니다.
그래서 Main은 질문을 해결하고 화면용 답변을 만드는 데 집중하고, Speech Text는 Main의 최종 답변만 받도록 나눴습니다. Speech Text에는 대화 이력 전체를 넘기지 않습니다. 매 턴 지침과 최종 답변으로 새 context를 만들어, 이미 결정된 내용을 발화에 맞게 바꿉니다.
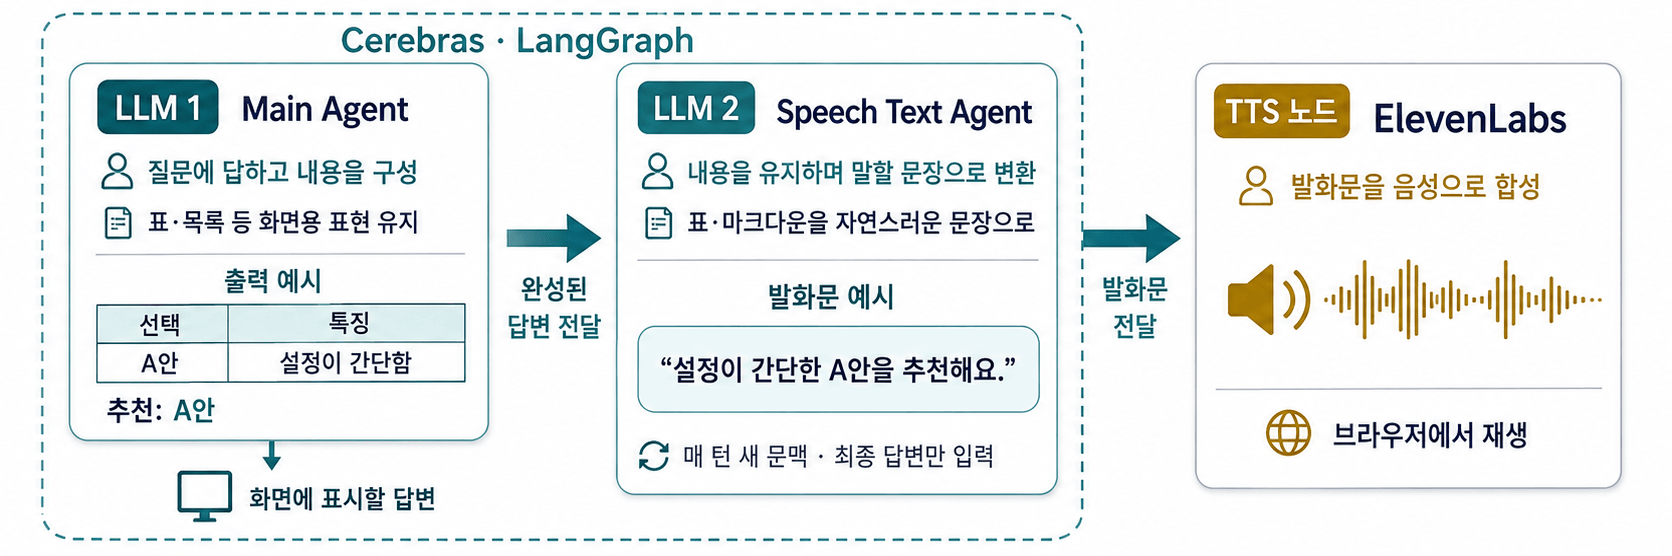
기본 지침은 요약보다 표현 변환에 가깝습니다. 표와 목록을 문장으로 풀고, 서식·인용 표시는 걷어내며, 말로 전달할 내용을 유지하도록 요청합니다. 긴 표나 반복 설명에는 압축을 허용하므로 모든 문장을 그대로 읽는 계약은 아닙니다. 발화문이 완성되면 TTS에 전달합니다.
이 선택은 LLM 호출을 한 번 더 사용합니다. 정제 단계의 시간과 토큰 사용량을 따로 남겼지만, 정제를 생략한 경로와의 대조 실험은 아직 없습니다. 같은 Main 답변을 직접 읽는 경우와 정제해 읽는 경우의 지연·비용·전달 차이는 두 번째 글의 S04 계획에서 비교하도록 했습니다.
04 · 입력 종료
버튼을 놓은 뒤에도 왜 전사를 기다려야 할까요?
초기 C-PTT는 버튼을 놓는 순간 화면에 있던 임시 전사(partial)를 포함해 제출하고 STT 연결을 닫았습니다. 아직 인식 중인 문장이 LLM에 들어갈 수 있었고, 오디오를 모아 보내는 버퍼의 마지막 PCM도 즉시 종료할 때 빠질 수 있었습니다. PCM은 마이크 신호를 숫자 표본으로 담은 오디오 데이터입니다.
현재는 “말하세요”를 표시하는 시점부터 바꿨습니다. 토큰 발급과 마이크 준비뿐 아니라 Scribe의 모델·언어·오디오 설정이 요청과 맞는지 확인하고, 캡처가 시작된 뒤 입력을 받습니다. 버튼을 놓으면 남은 PCM을 끝까지 전송한 후 manual commit으로 전사 확정을 요청합니다. 확정 전사(final)를 받아야 LLM에 질문을 제출합니다.
| 경계 | 확인한 뒤 넘기는 값 | 실패·취소 처리 |
|---|---|---|
| 준비 → 입력 | 마이크와 Scribe 설정 확인, 캡처 시작 | 준비 중 취소되면 뒤늦게 열린 마이크도 정리 |
| 입력 → 확정 요청 | 버튼 release 후 잔여 PCM 전송 완료 | 30초 입력 제한에서 자동 확정 |
| 확정 요청 → LLM | manual commit 뒤 받은 확정 전사 | 8초 final timeout 또는 빈 final은 오류로 종료; partial 대체 제출 없음 |
| 제출 → 진단 | 실제 전송 sample 수, 준비 시간, release→final 시간 | final 실패 입력은 agent 턴으로 남지 않아 로컬 입력 진단으로 확인 |
선택 녹음에는 STT에 실제로 보낸 PCM을 WAV로 담습니다. 보정 전의 원시 마이크 신호와 구분하고, 최근 입력 한 개만 브라우저 탭 메모리에 보관합니다. STT 비용 계산도 버튼을 누른 전체 시간 대신 실제 전송한 sample 수를 사용하도록 바꿨습니다. 이 변경 이후 기록에는 입력 처리 버전을 함께 남깁니다.
05 · 검증 범위
수정이 지킨 순서는 어떻게 확인했을까요?
2026-09-06 수정 기록에는 자동 테스트, 실제 Scribe 계약 확인, 합성 입력과 mock 서버를 사용한 브라우저 검증이 남아 있습니다. 각각 확인하는 경계가 달라 아래처럼 나눠 읽었습니다.
| 검증 종류 | 입력과 확인한 결과 | 확인 범위 |
|---|---|---|
| 자동 테스트 | Frontend 23개·backend 21개 통과 기록 | final만 제출, tail flush, 준비 중 취소, timeout, 진단 schema와 입력 길이 계산 등 |
| 실제 Scribe 계약 | Yuna 합성 음성 0.88초·2.13초를 PCM16/16kHz로 전송; 두 입력 모두 final 수신 | manual commit과 확정 전사 응답 계약 |
| 브라우저 + mock | 전송 PCM 12,032 bytes와 다운로드 WAV payload 일치; 입력 길이 376ms 일치 | 실제 worklet의 잔여 전송, final 전 소켓 유지, partial 미제출, 준비 중 release 취소 |
| 중단 시 사용량 | Realtime 중단·취소 뒤 늦게 도착한 usage 처리 테스트 | 늦은 사용량을 중단된 이전 턴에 보존하고 새 턴과 구분하는 동작 |
합성 음성이 final을 돌려준 것은 입력·출력 계약의 확인입니다. 사용자의 마이크 인식 품질이나 수정 후 응답 속도를 재측정한 결과는 아닙니다. 초기 사용자 기록 44턴은 이 STT 종료 수정 전에 수집됐으며, 수정 전후의 성능 비교 자료로 합치지 않았습니다.
응답을 추적할 때는 한 번의 질문과 답변에 공통 turn ID를 붙입니다. 처리 구간과 이벤트를 연결하는 tracing에 OpenTelemetry를 사용하고, 저장된 trace는 LangSmith에서 확인하도록 구성했습니다. 브라우저의 입력 종료·첫 출력과 서버의 생성·사용량을 같은 턴에서 읽을 수 있습니다. 첫 토큰과 첫 오디오, 실제 브라우저 출력은 별도 사건으로 남깁니다.
두 경로를 연결한 뒤 남은 질문은 어느 구간에서 기다렸고 그 턴에 얼마의 사용량이 생겼는지입니다. 다음 글에서는 측정 시작점을 구분하고, 수정 전 초기 44턴의 지연과 추정 비용을 해석합니다.