에이전트가 요청에 맞는 화면을 선택하고, 그 안의 정보와 선택 상태를 바꾸는 앱을 만들었습니다. 서울 외출 계획을 사례로 이 방식을 시험했습니다.
01 · 기획 의도
에이전트가 미리 만든 화면을 선택하게 하기
이 프로젝트는 AG-UI와 A2UI에서 본 ‘에이전트가 화면을 바꾼다’는 아이디어에서 시작했습니다. 자연어로 요청하면 에이전트가 정보를 모으고, 질문에 맞는 화면과 데이터를 함께 보여주는 앱을 만들고 싶었습니다.
당시 제가 접한 에이전트는 결과를 Markdown으로 길게 출력하거나, Claude Code처럼 HTML·CSS·JavaScript로 화면을 만들었습니다. 요청마다 구성과 동작이 달라, 생성한 코드를 서비스에 그대로 넣기에는 실행 권한과 화면 품질을 통제하기 어려웠습니다.
설계 방향
카드·지도·경로 비교·공유 화면은 제품 코드로 준비하고, 에이전트에는 화면을 선택하고 데이터를 바꾸는 도구를 제공했습니다. 생성한 HTML이나 JavaScript를 실행하는 권한은 주지 않았습니다.
02 · 적용할 문제
여러 조건에 맞는 장소를 비교하고 고르기
“맛있는 곳인데, 아이와 가기 좋고 주차도 편했으면 좋겠다.” 외출 장소를 고를 때는 이런 조건이 함께 붙습니다. 추천 목록을 본 뒤에도 리뷰와 상세 정보, 지도를 오가며 각 조건에 맞는지 직접 비교해야 합니다.
이 비교를 LLM이 도울 수 있다고 생각했습니다. 수집한 정보에서 조건에 맞는 근거를 찾아 설명하고, 후보와 지도를 함께 보여주려 했습니다. 사용자가 조건을 바꾸면 비교할 장소와 화면도 그에 맞춰 갱신하는 것이 목표였습니다.
서울 외출 계획을 고른 이유
외출 계획에는 장소 탐색, 경로 비교, 일정 공유처럼 서로 다른 화면이 필요해 이 설계를 시험하기 좋았습니다. 서울 열린데이터광장의 공공예약·공영주차장 정보와 장소 검색·지도·경로 API를 연결했습니다. 완성한 앱은 2026 서울시 빅데이터 활용 경진대회 창업 부문에 출품했습니다.
03 · 도구 호출과 상태 관리
에이전트의 도구 호출을 화면에 반영하기
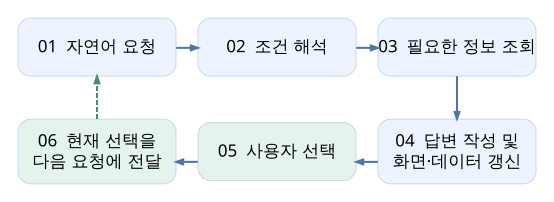
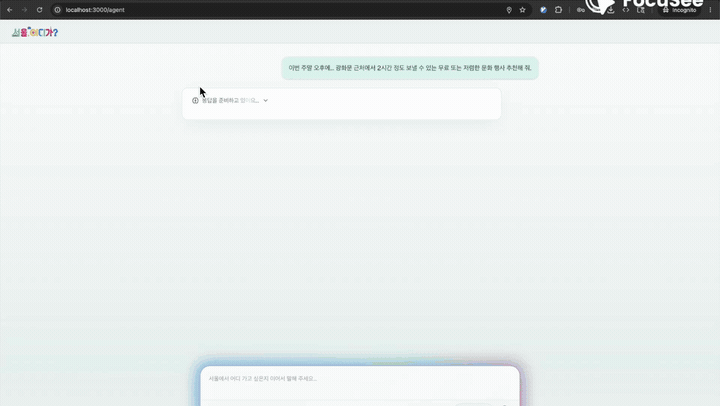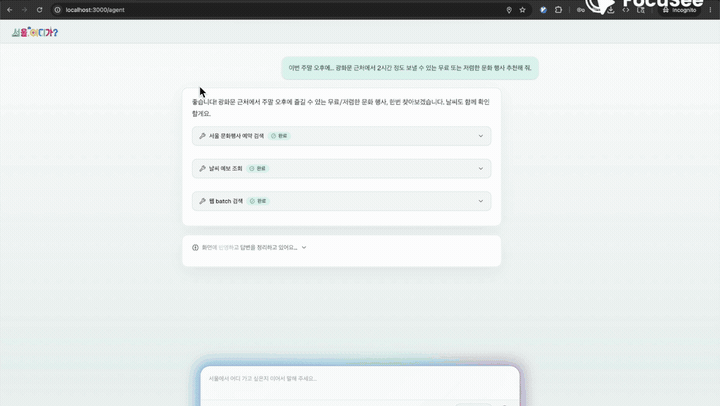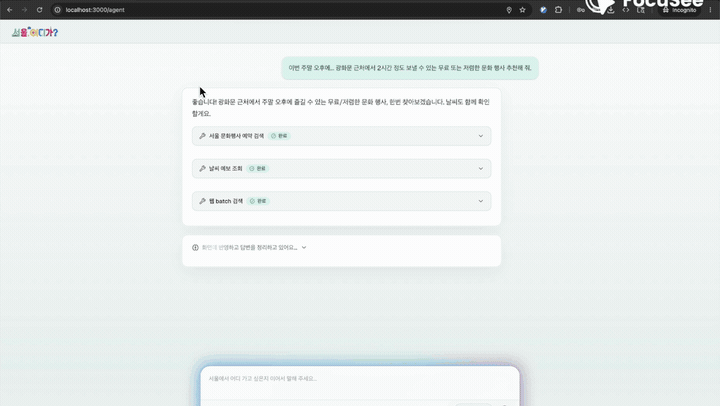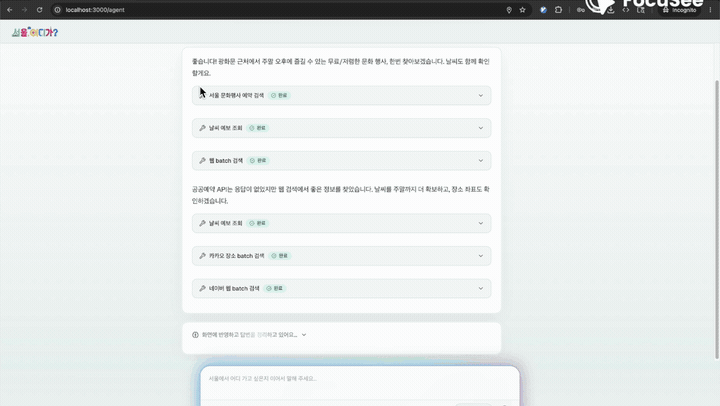
메인 에이전트는 요청을 해석해 필요한 검색 도구를 호출하고, 결과에서 답변과 화면용 데이터를 구성합니다. 정보 조회는 서버에서 실행하고, 화면 변경은 브라우저가 도구 호출을 받아 처리합니다.
에이전트에 제공한 도구
도구 33개를 정보 조회 19개, 화면·선택 상태 변경 11개, 상태 확인·결과 출력 3개로 나눠 제공했습니다. 표의 scene은 작업에 필요한 화면 조합, frame은 그 안의 배치를 뜻합니다.
| 역할 | 제공한 tool | 담당하는 일 |
|---|---|---|
| 주차 | seoul_search_public_parking_lots | 서울시 공영주차장 정보를 검색합니다. |
| 공공예약 | seoul_search_public_reservations_batchseoul_search_public_culture_reservationsseoul_search_public_education_reservationsseoul_search_public_space_reservationsseoul_search_public_sport_reservations | 문화·교육·공간·체육 예약 정보를 분야별로 조회하거나 묶어서 검색합니다. |
| 장소 검색 | maps_search_kakao_placesmaps_search_kakao_places_batchmaps_search_naver_localmaps_search_naver_local_batch | 카카오 장소 검색과 네이버 지역 검색으로 후보 장소를 찾습니다. batch는 여러 검색을 묶습니다. |
| 경로 조회 | maps_request_tmap_pedestrian_routemaps_request_tmap_car_routemaps_request_tmap_transit_routemaps_request_tmap_route_batch | TMAP으로 도보·자동차·대중교통 경로를 조회합니다. batch는 여러 경로 요청을 묶습니다. |
| 웹 검색 | web_search_naverweb_search_naver_batchweb_search_firecrawlweb_search_firecrawl_batch | 네이버와 Firecrawl을 통해 웹의 보충 정보를 검색합니다. |
| 날씨 | weather_get_open_meteo_forecast | Open-Meteo에서 외출 계획에 필요한 날씨 예보를 조회합니다. |
| 역할 | 제공한 tool | 담당하는 일 |
|---|---|---|
| 화면 전환 | frame_open | 등록된 frame을 열고 scene을 설정합니다. |
| 장소 표시·선택 | route_set_placesplace_select | 지도와 상세 화면에 쓸 장소 목록을 설정하고, 현재 장소를 선택합니다. |
| 경로 비교·선택 | route_set_candidatesroute_select_route | 경로 후보 목록을 설정하고, 비교 중인 경로를 선택합니다. |
| 지도 위치 | route_set_viewport | 지도의 중심과 확대 수준 등 viewport를 갱신합니다. |
| 선택지 구성 | selection_set_optionsselection_open_modal | 후보 카드를 구성하고 선택 모달을 엽니다. |
| 선택 결과 | selection_select_optionselection_add_selected_items | 활성 후보를 바꾸거나 선택한 항목을 목록에 추가합니다. |
| 공유 화면 | share_set_state | 공유할 일정 요약, 대상, 경유지와 구간 정보를 설정합니다. |
| 역할 | 제공한 tool | 담당하는 일 |
|---|---|---|
| 현재 맥락 읽기 | ui_get_current_frame_state | 브라우저가 요청에 첨부한 UI 스냅샷을 읽습니다. 실행 중의 DOM을 조회하지는 않습니다. |
| 대화 속 카드 | assistant_render_card_grid | 구조화한 카드 데이터를 대화 안의 미리 구현된 카드 그리드에 전달합니다. |
| 음성 발화 준비 | voice_prepare_speech | 화면 답변과 별도로 짧은 발화문을 준비해 TTS 출력에 사용합니다. |
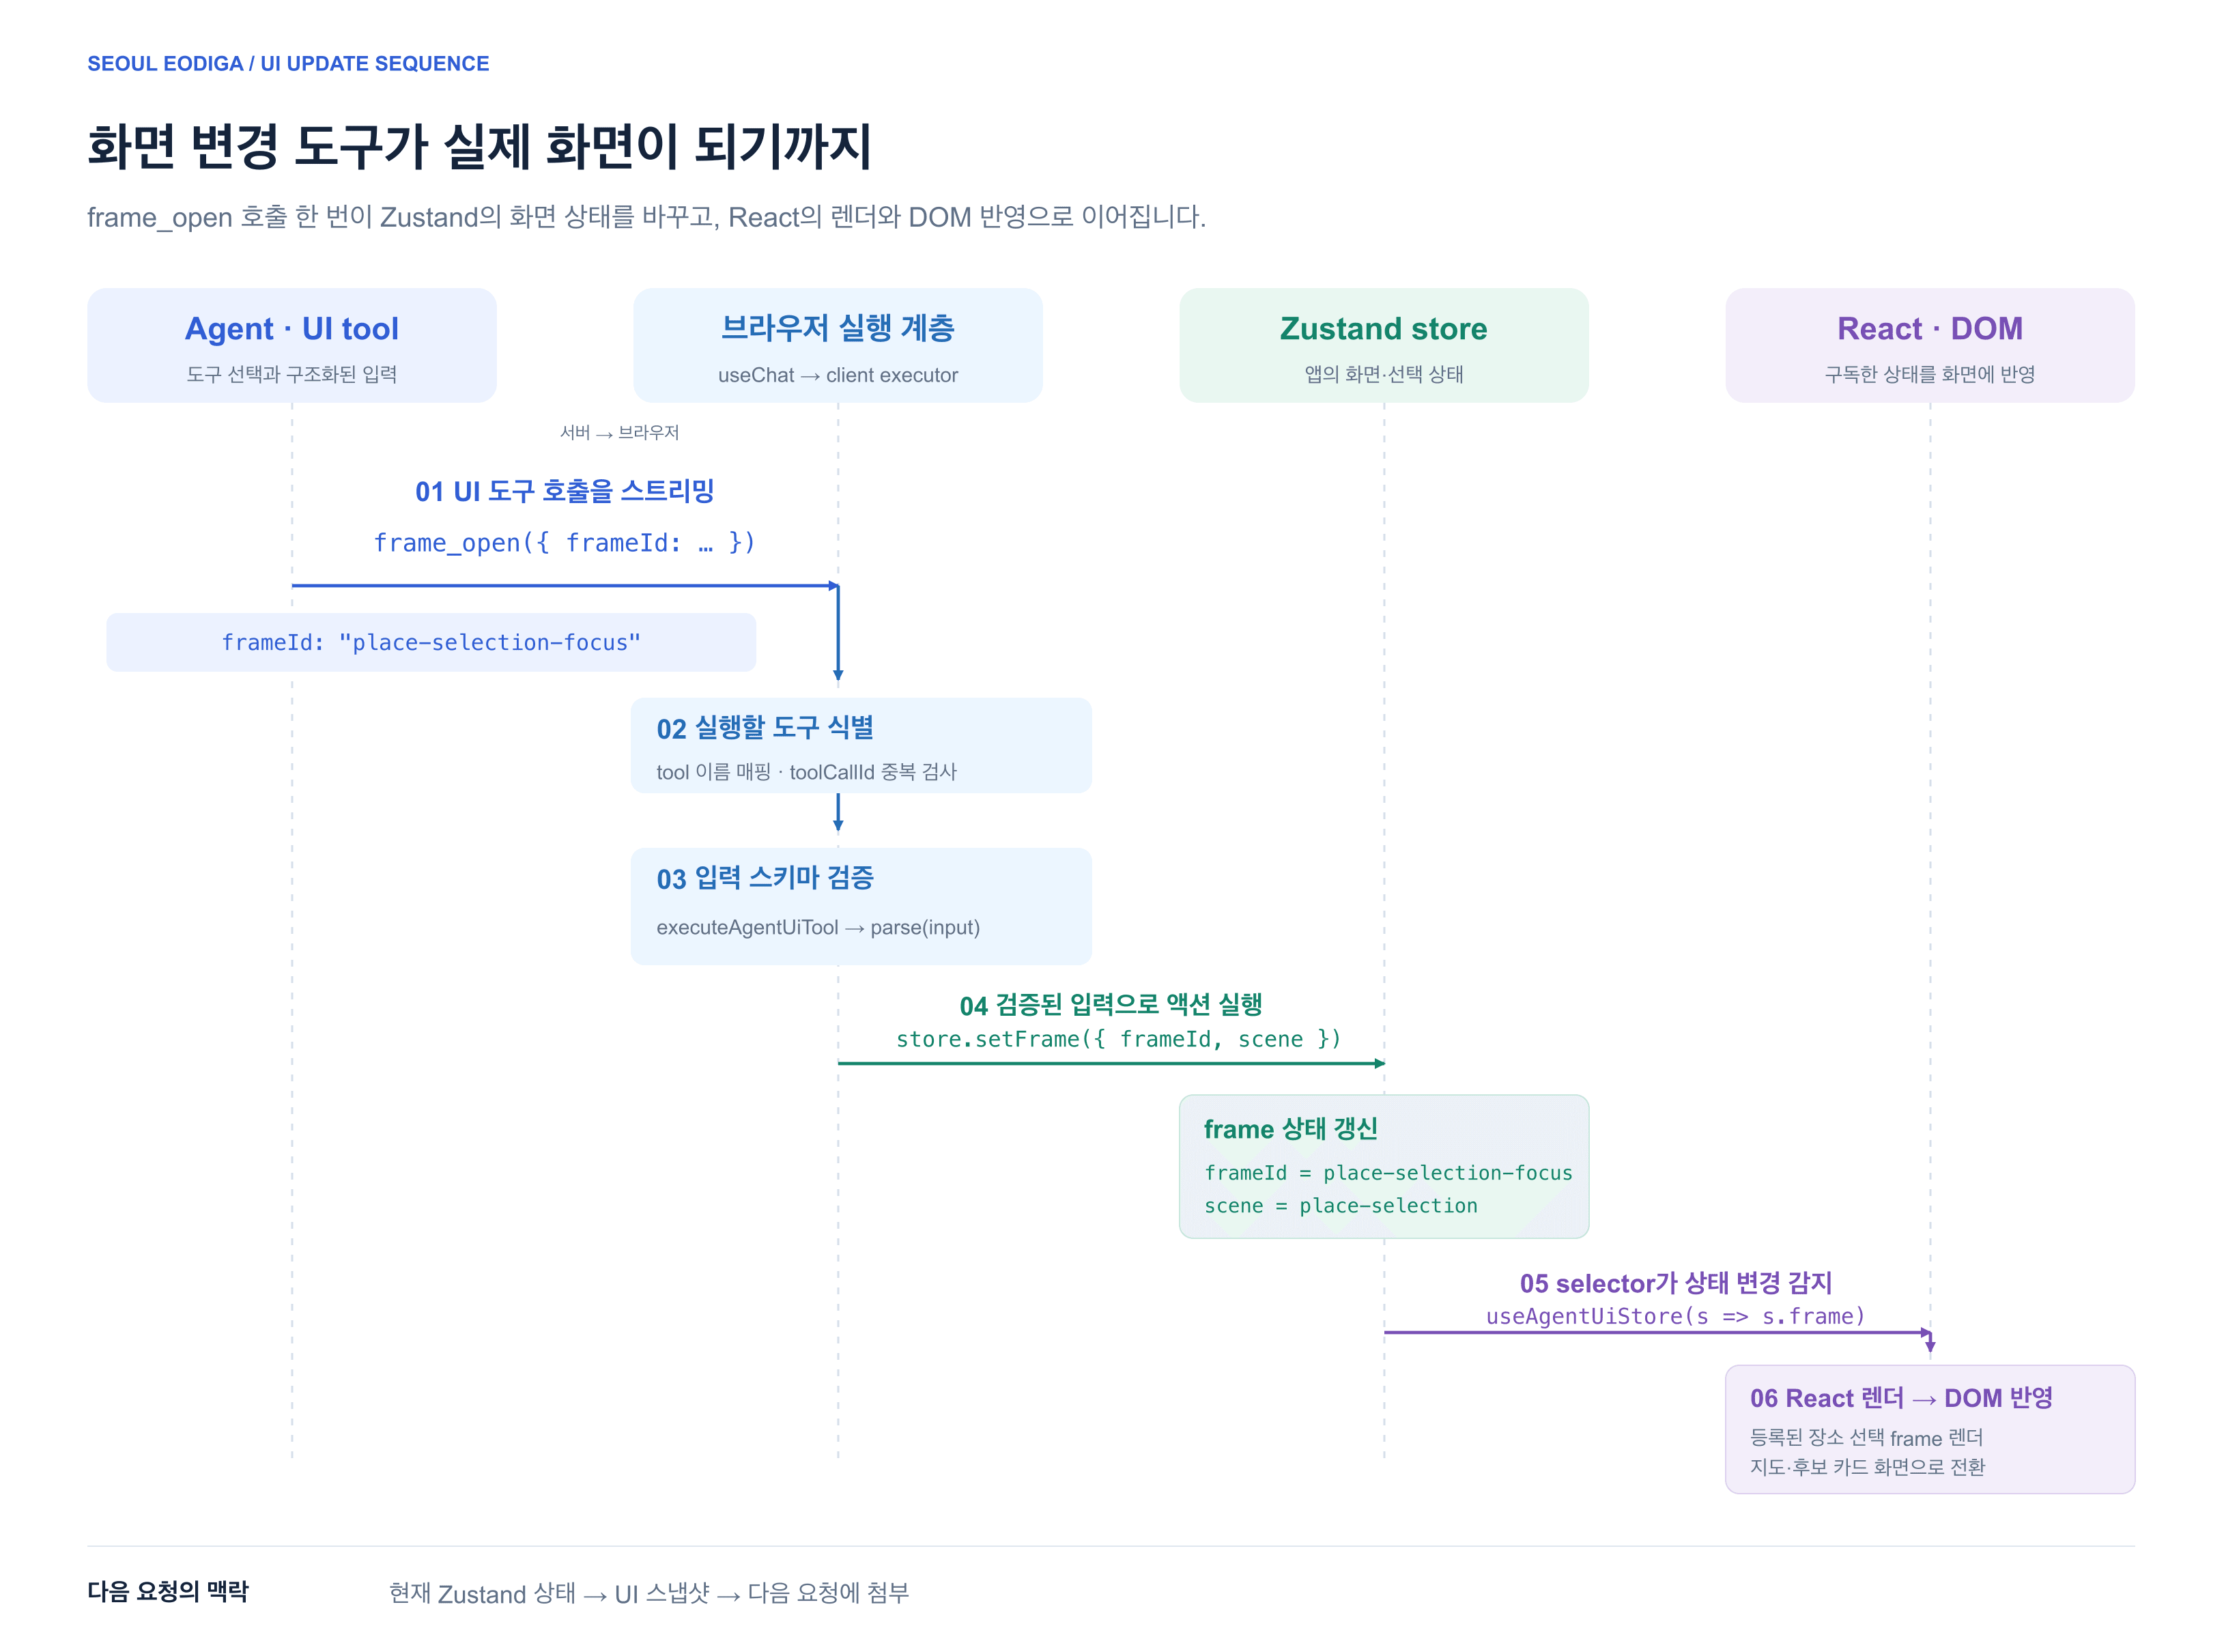
화면 변경 도구의 입력 형식은 스키마로 정했습니다. 브라우저는 응답 스트림에서 도구 호출을 읽고 입력을 다시 검증한 뒤, 해당 Zustand 액션을 실행합니다. React는 바뀐 상태를 읽어 컴포넌트를 렌더링하고 DOM에 반영합니다.
구현 코드: 메인 에이전트의 도구 등록 · 브라우저의 UI 도구 실행
대화 상태와 앱 상태를 나눈 이유
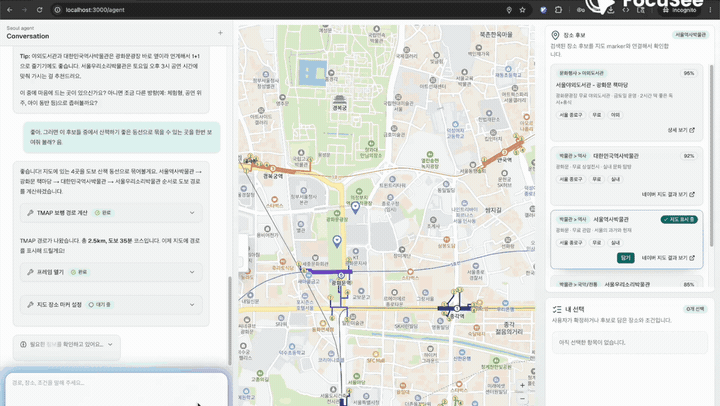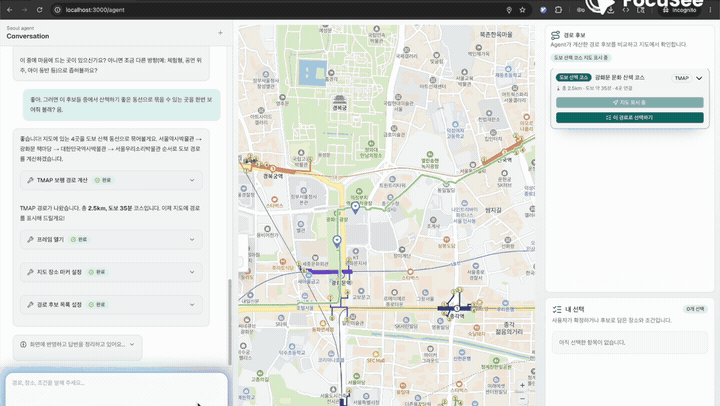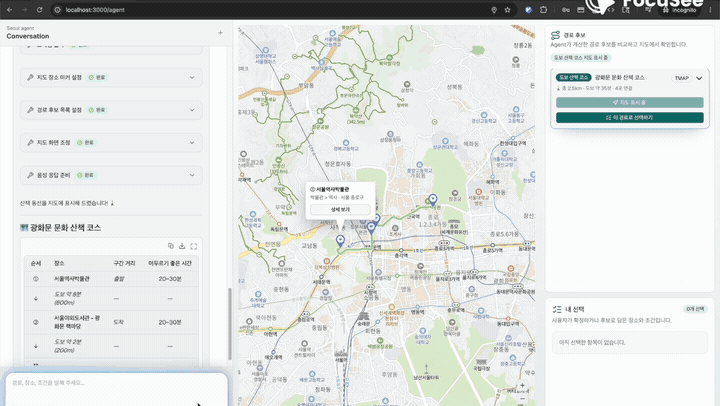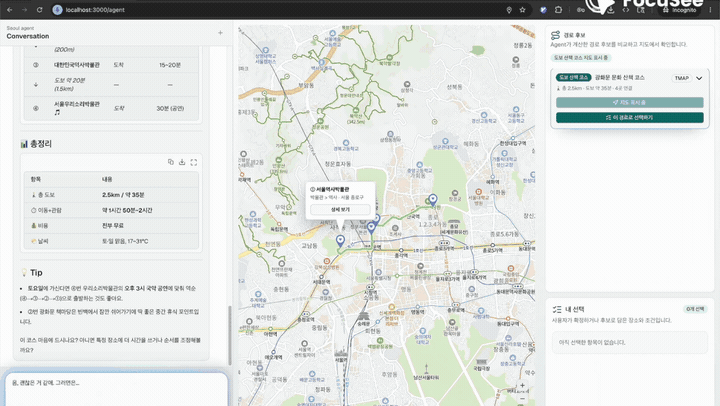
지도에서 장소를 누르면 카드와 지도에 같은 선택이 즉시 반영되어야 했습니다. 에이전트의 응답을 기다리지 않고 여러 화면을 함께 갱신하기 위해, 앱 상태를 Zustand에 모았습니다. 사용자 클릭과 에이전트의 도구 호출은 같은 상태 변경 함수를 사용합니다.
Next.js 클라이언트에서 AI SDK의 useChat은 메시지·응답 스트림·요청 상태와 중단을 맡습니다. Zustand는 현재 화면, 장소·경로 후보와 선택, 지도 위치, 일정·공유 데이터, 음성 UI 상태를 관리합니다. 각 화면은 대화 메시지에서 선택을 다시 해석하는 대신, selector로 필요한 값을 구독합니다.
저장소는 ApplicationFrameShell의 Provider에서 한 번 생성해 하위 화면이 공유합니다. 같은 셸 안에서 화면을 전환해도 선택과 일정이 유지됩니다. useChat의 요청 상태는 UI 표시에 필요한 값만 저장소에도 반영합니다.
다음 요청에는 현재 화면, 선택 ID, 후보 수를 추린 UI 스냅샷을 첨부합니다. 사용자가 지도나 카드에서 바꾼 선택을 에이전트도 다음 답변에 참고할 수 있습니다.
ui_get_current_frame_state는 이 요청 당시의 스냅샷을 읽습니다. 도구 실행 뒤의 화면이나 실제 DOM을 확인하지는 못하므로, 화면 변경 결과를 다시 전달하는 기능은 남은 과제입니다.
구현 코드: useChat과 요청 전송 · Zustand 저장소와 스냅샷
04 · 화면 배치의 설계와 시행착오
자유로운 격자 배치에서 미리 정한 화면으로
설계: X11 타일링 윈도 매니저처럼 배치하기
처음에는 X11의 타일링 윈도 매니저처럼 화면을 나눠 보려 했습니다. 채팅·지도·상세 정보를 pane이라는 화면 영역으로 등록하고, 에이전트가 요청에 맞춰 각 pane의 위치와 크기를 정하게 했습니다.
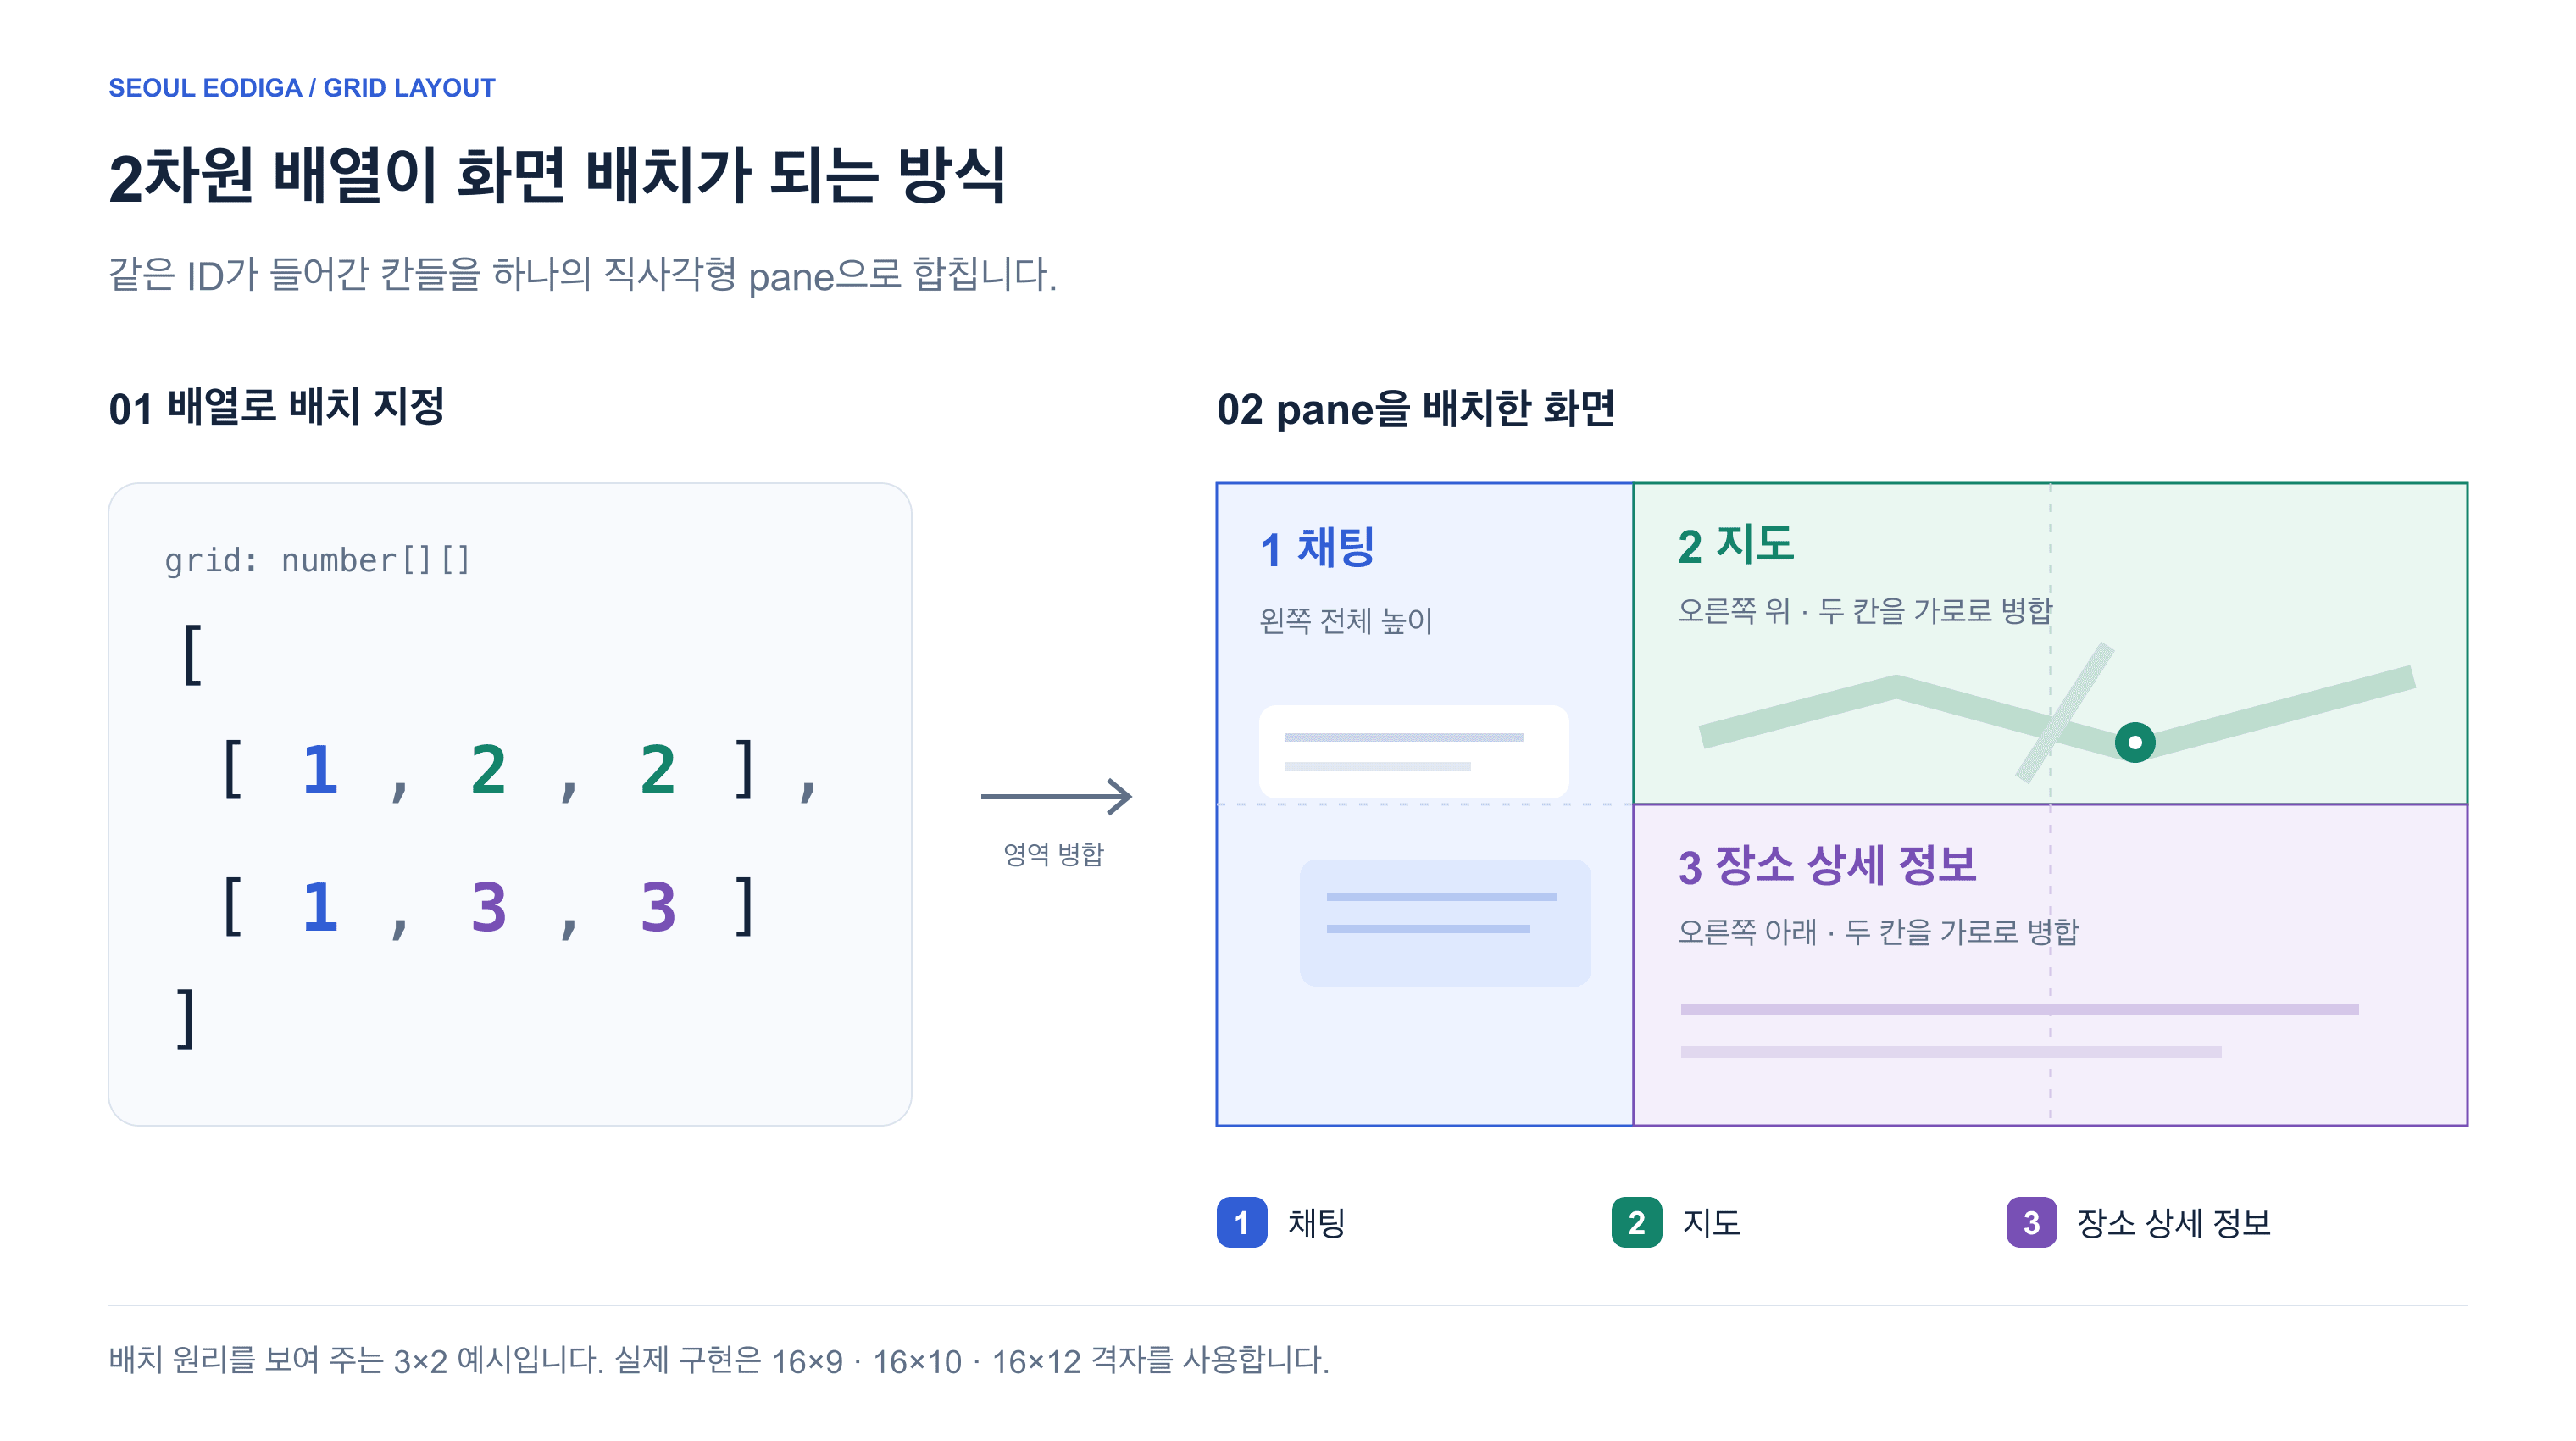
배치는 number[][] 형태의 2차원 배열로 표현했습니다. 같은 pane ID가 들어간 칸들을 직사각형으로 묶고, 그 영역을 CSS Grid의 위치와 크기로 변환했습니다.
ID는 1이 채팅, 2가 지도, 3이 장소 상세 정보입니다. 초기에는 0을 빈칸으로 썼지만, 이후에는 등록된 ID로 모든 칸을 채우도록 스키마를 바꿨습니다.
아래는 원리를 설명하기 위한 3×2 예시입니다. 실제 배치 계획에는 16×9, 16×10, 16×12 격자를 사용했습니다.
문제: 비율을 제한해도 pane 안의 UI는 깨졌다
실제로는 pane이 너무 작아져 카드와 지도 컨트롤이 밀리는 배치가 자주 나왔습니다. 이를 막으려고 화면 비율을 16:9·16:10·4:3으로 제한하고, pane마다 최소 너비·높이 비율을 두었습니다. 같은 pane이 떨어져 있거나 직사각형을 이루지 않는 배열도 검증했습니다.
비율과 배열 검증을 통과해도 내부 UI는 계속 깨졌습니다. 모델에는 화면 크기와 pane의 역할·최소 크기를 텍스트로 전달했지만, 실제 렌더링 화면은 보여주지 않았습니다. 카드의 줄바꿈과 스크롤까지 확인하며 배치할 수 없었고, 예외를 설명하는 프롬프트만 길어졌습니다.
변경: 배치와 크기는 프런트엔드에서 관리하기
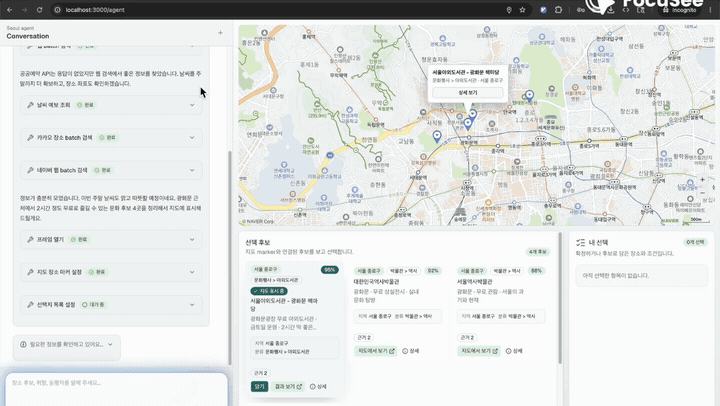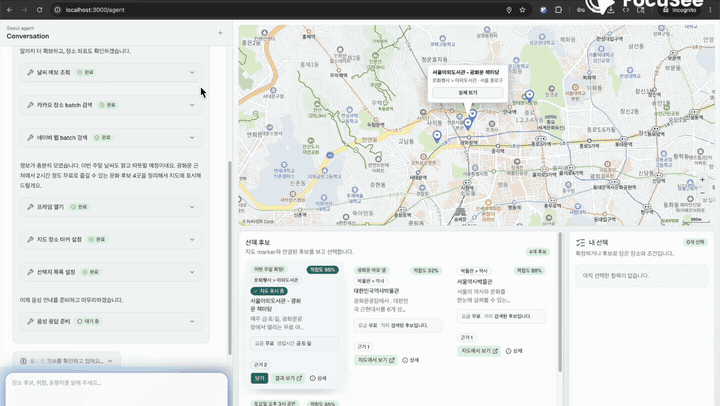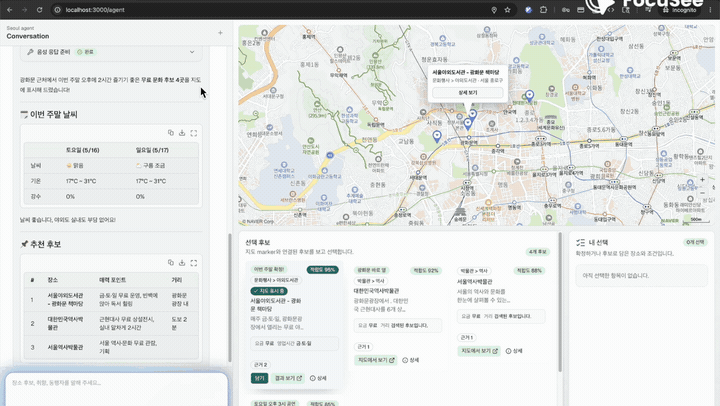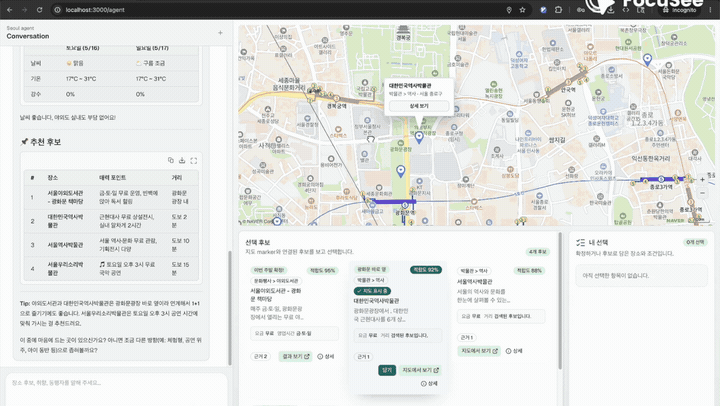
제품 화면에서는 장소 선택·경로 확인·일정 공유에 맞는 화면 조합(scene)과 배치(frame)를 미리 만들었습니다. React가 배치와 반응형 조정, 모달 동작을 맡고, 에이전트는 사용할 화면과 표시할 데이터를 결정합니다. 자유로운 격자 생성은 실험용 모듈로 남겼습니다.
올바른 배열을 생성하는 것만으로는 읽기 좋은 화면을 보장할 수 없었습니다. 모델에 맡길 범위를 화면 선택과 데이터 구성으로 좁힌 이유입니다.
구현 코드: 2차원 격자 계약 · pane 크기 검증 · scene·frame 전환 결정
AG-UI·A2UI와의 관계
A2UI 공식 문서는 UI를 선언적인 데이터로 표현하고, 신뢰하는 컴포넌트로 렌더링하는 방식을 설명합니다. AG-UI 공식 문서는 에이전트와 앱이 양방향으로 상호작용하는 프로토콜을 설명합니다.
이 프로젝트는 두 규격을 직접 구현하지는 않았습니다. 아이디어를 참고하되, 구현에는 AI SDK의 도구 호출과 자체 화면·상태 도구를 사용했습니다.
05 · 일정 공유
선택한 장소와 이동 순서를 다시 입력하지 않게
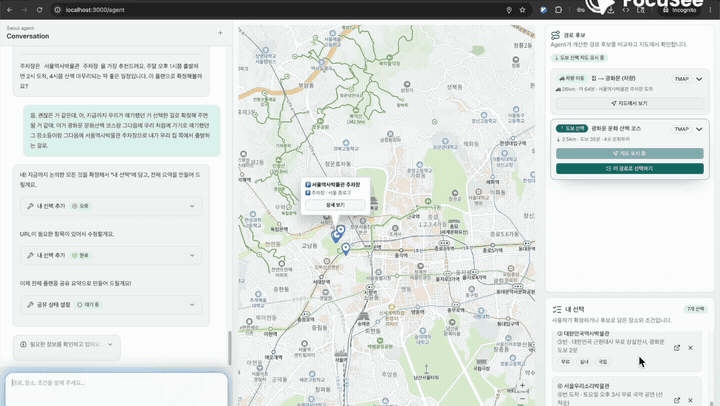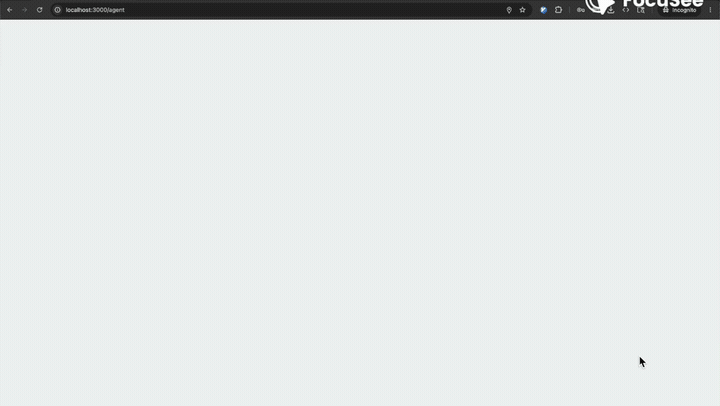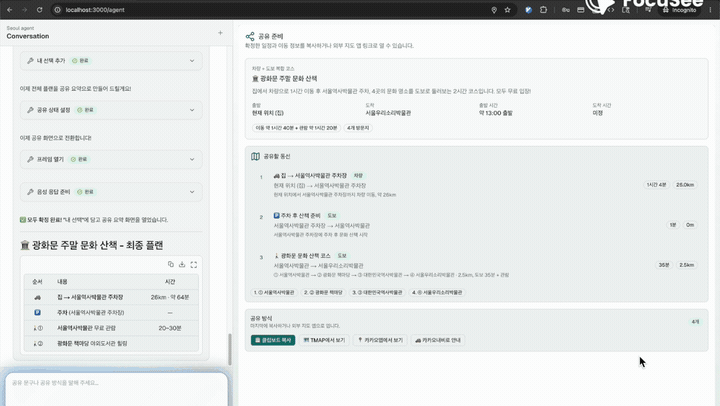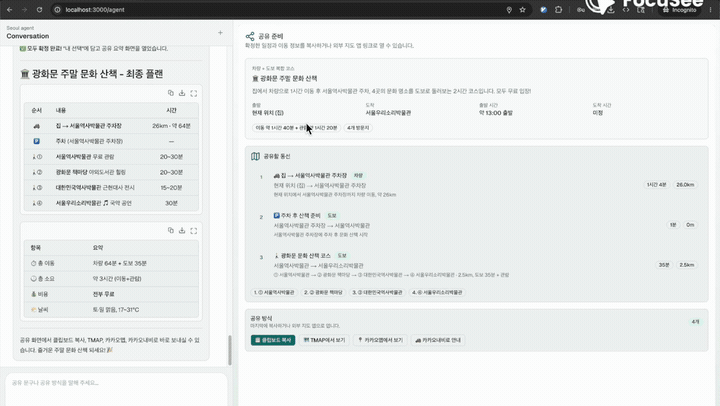
검색할 때는 후보를 비교할 상세 정보가 필요하고, 공유할 때는 확정한 장소와 이동 순서가 중요했습니다. 공유 화면이 기존 선택과 일정을 읽어 요약하게 해, 사용자가 같은 정보를 다시 입력하지 않게 했습니다.
06 · 음성으로 조건 바꾸기
말로 요청하고, 화면에서 비교하기
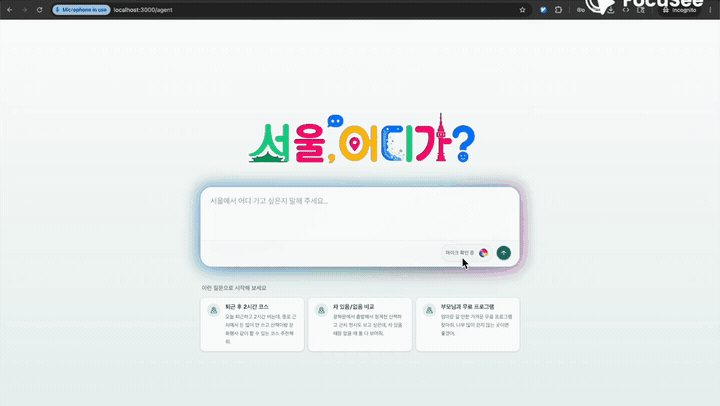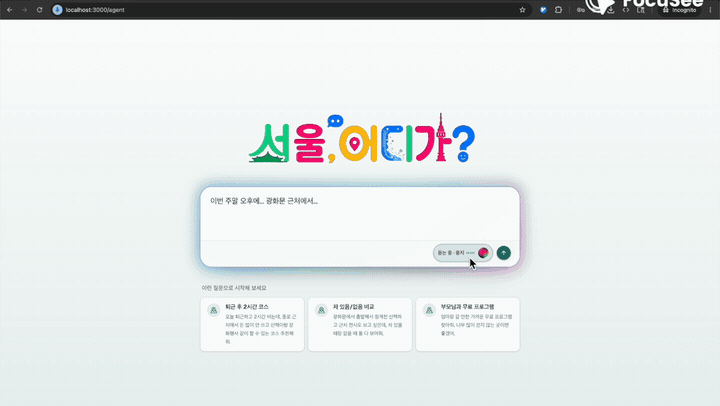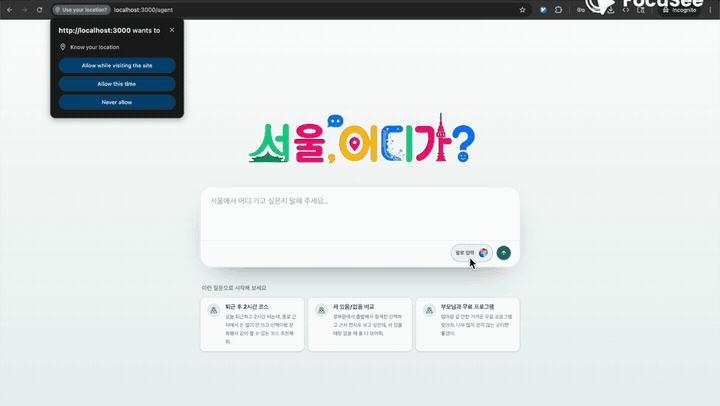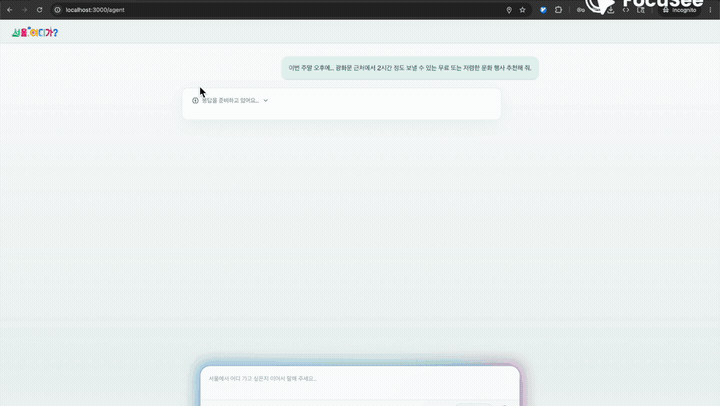
화면을 보면서 “두 번째 장소로 바꿔줘”라고 요청할 수 있게 음성 입력을 붙였습니다. 음성을 글로 변환한 결과는 타이핑한 요청과 같은 경로로 처리합니다. 동행인이나 이동수단을 말로 바꾸면서도 현재 선택과 일정을 이어서 수정할 수 있습니다.
표와 링크가 포함된 답변은 그대로 읽으면 듣기 불편했습니다. voice_prepare_speech로 결과와 다음 선택을 짧은 문장으로 준비하고, ElevenLabs TTS가 읽게 했습니다. 후보별 상세 정보는 화면에 남겼습니다.
07 · 단일 에이전트에 모든 일을 맡긴 대가
검색·화면·음성 출력을 한 모델에 맡겼을 때
설계: 한 에이전트가 모든 단계를 수행하기
초기 구조에서는 한 에이전트가 조건 해석, 검색, 후보 비교, UI 데이터 구성, 화면 전환, 답변과 음성 요약까지 맡았습니다. 역할별 도구를 모두 제공하고, 앞선 결과를 다음 도구의 입력으로 넘겨 작업을 마치게 했습니다.
문제: 응답 지연과 마지막 단계의 누락
정보 검색 뒤에도 조회 결과를 카드·지도·경로 화면에 맞게 구성해야 했습니다. UI에 넣을 데이터와 답변을 모두 생성하는 동안 사용자의 대기 시간이 길어졌습니다.
필수 단계도 빠졌습니다. 마지막에 voice_prepare_speech를 호출하도록 지시했지만, 검색과 화면 갱신을 마치고도 발화문을 준비하지 않는 실행이 있었습니다.
시도: 빠른 추론 공급자와 E2E smoke test
응답 시간을 줄이려고 Cerebras 같은 빠른 추론 공급자를 연결했습니다. 이때도 많은 도구와 지침을 한 번에 제공한 구성에서 호출 누락이나 잘못된 순서·입력이 나왔습니다. 생성이 빨라도 필요한 작업을 끝내지 못하면 앱에서 쓸 수 없었습니다.
모델을 고를 때는 주요 요청을 끝까지 실행하는 간단한 E2E smoke test를 사용했습니다. 첫 응답 속도와 함께 검색, 화면 갱신, 최종 출력이 이어지는지 확인했습니다.
실제 사용 모델은 DeepSeek V4 Pro입니다. Flash와 같은 가벼운 모델로는 작업을 안정적으로 수행하기 어려웠습니다. 정식 성능 벤치마크 대신 앱에서 필요한 작업을 수행하는지 점검한 결과로 선택했습니다.
배운 점: 판단할 작업과 반드시 실행할 단계를 구분하기
호출 누락을 겪으면서, 한 모델이 매번 모든 단계를 기억해 수행하도록 맡긴 설계를 다시 보게 됐습니다. 검색과 UI 데이터 구성은 필요한 도구와 지침이 달랐고, 음성 준비는 실행 여부를 모델에 맡길 필요가 없는 마무리 단계였습니다.
후속 설계에서는 정보 수집과 화면 구성을 subagent로 나누는 방안을 검토하게 됐습니다. 각 역할에는 필요한 도구와 맥락만 주고, 음성 준비는 정해진 실행 단계로 연결하는 방식입니다. 역할 분리에 따른 호출·전달 비용이 늘어나는 만큼 지연과 작업 성공률은 다시 검증해야 합니다.
서울 어디가?에서 역할 분리까지 완성하지는 못했습니다. 이후 로디 복지 상담 에이전트 등 다른 프로젝트에서도 에이전트의 역할과 전달할 맥락을 따로 설계해야 한다는 점을 떠올려 반영했습니다.
08 · 구현 범위와 남은 과제
화면 제어는 구현했고, 추천 품질은 더 검증해야 합니다
이 프로젝트에서 구현한 범위와 그 목적은 자연어 요청을 검색과 화면 상태 변경으로 연결하고, 화면에서 고른 항목을 다음 대화에 전달하는 데까지입니다.
추천의 품질은 별도로 검증해야 합니다. 특히 ‘아이와 가기 좋은지’, ‘주차가 편한지’를 설명할 때 수집한 정보가 근거를 뒷받침하는지 확인해야 합니다. 확인하지 못한 조건을 구분해 표시하는지, 실제 비교와 선택에 도움이 되는지도 남은 검증 항목입니다.
실제 운영에는 정보 출처와 확인 시점 표시, API 장애 대응, 호출 한도·캐시 관리, 위치정보 보관 정책도 필요합니다. UI를 정해진 범위로 제한한 설계를 바탕으로, 정보의 신뢰성과 필수 단계의 실행을 함께 보완해야 합니다.