01
빠른 LLM이 첫 음성 응답까지 이어질까?
음성 대화에서는 사용자가 말을 마친 뒤에도 기다림이 이어집니다. STT는 입력 음성을 텍스트로 바꾸고, LLM은 답변을 생성하며, TTS는 답변을 음성으로 합성합니다. 첫 글자가 빨리 나와도 발화문을 정리하고 합성한 오디오가 브라우저에서 재생되기까지 시간이 더 걸립니다.
이 프로젝트는 Cerebras로 LLM 추론을 가속한 STT → LLM → TTS 조합과 음성을 직접 입출력하는 OpenAI Realtime을 구성했습니다. 비교하려는 것은 첫 음성 출력까지의 지연과 전체 음성 경로의 비용입니다. 이 글에서는 측정 경계를 설명하고, 2026년 9월 6일의 초기 사용자 기록에서 확인한 값과 후속 실험 계획을 나눠 살펴봅니다.
| 경로 | 입력에서 출력까지 | 비용에 포함하는 항목 |
|---|---|---|
| Cerebras cascade | Scribe v2 Realtime → gpt-oss-120b의 답변 생성 → 같은 모델의 Speech Text → ElevenLabs Flash v2.5 | STT 오디오 시간 + Main·Speech Text의 token + TTS 문자 |
| OpenAI Realtime | gpt-realtime의 음성 입력·출력 · voice: marin | text·audio의 입력·출력 token과 cached input |
현재 비교 세션은 양쪽 모두 tools=[]입니다. 일반 Cerebras 경로에는 API 키가 있을 때 Firecrawl 검색 도구를 등록하지만, 비교 세션은 도구를 빼고 실행하도록 나눴습니다. 공통 도구를 연결한 비교는 뒤에서 설명할 추가 구현 과제입니다.
화면용 답변과 발화문을 분리한 이유, 두 음성 경로와 입력 종료 처리의 구현은 빠른 LLM을 음성 대화로 연결한 구조에서 설명합니다.
02
기다림은 어디에서 시작하고 끝납니까?
PTT(Push-to-Talk)는 버튼을 누른 동안 말하고 놓으면 입력을 끝내는 방식입니다. VAD(Voice Activity Detection)는 발화와 침묵을 감지해 종료를 정합니다. Cerebras의 PTT를 C-PTT, OpenAI의 PTT와 VAD를 각각 O-PTT와 O-VAD로 구분했습니다. 입력을 끝내는 규칙이 달라 측정 시작점도 함께 적어야 합니다.
| 모드 | 입력 종료 뒤의 처리 | 첫 출력 지연의 시작점 |
|---|---|---|
| C-PTT | 잔여 PCM(마이크 오디오 표본) 전송 → 확정 전사(final) 수신 → LLM 요청 | 버튼 release · 현재 구현에서는 final 전사 대기 포함 |
| O-PTT | VAD 비활성화 → 수동 commit → 응답 생성 요청 | 버튼 release · commit·응답 요청 포함 |
| O-VAD | server VAD의 발화 종료 감지 · 침묵 대기 설정 500 ms | 브라우저의 speech_stopped 이벤트 수신 · 수신 전 대기 제외 |
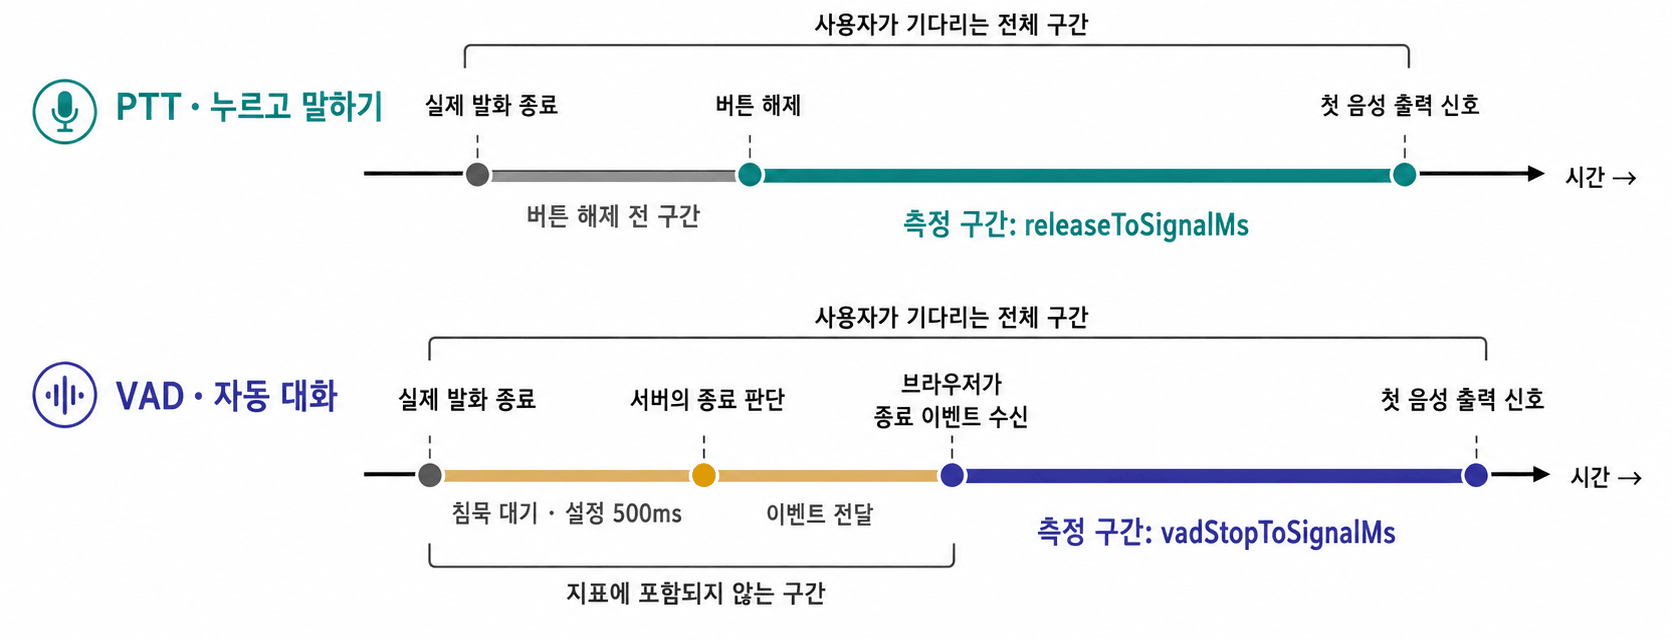
O-VAD의 지연에는 500 ms 침묵 대기와 종료 이벤트가 브라우저에 도착하기 전 시간이 빠집니다. PTT도 실제 발화가 끝난 순간과 버튼을 놓은 순간 사이를 측정하지 않습니다. 실제 발화 종료부터 비교하려면 공통 입력 음성의 종료 시각이 필요합니다. VAD 지표에 설정값 500 ms를 더하는 것만으로는 빠진 구간을 복원할 수 없습니다.
측정의 끝은 두 경로에 공통으로 둔 브라우저 출력 신호입니다. Web Audio로 오디오 신호의 크기를 나타내는 RMS를 매 animation frame에 확인하고, 재생 가능한 상태에서 RMS가 0.003 이상이 된 첫 시각을 기록합니다. 물리적인 스피커 소리를 측정한 값은 아니며, 재생 완료나 답변을 끝까지 들은 시각과도 구분합니다.
WebRTC와 WebSocket은 음성과 이벤트를 전달하는 연결 방식입니다. PTT·VAD처럼 발화 종료를 정하는 규칙과는 별도 조건입니다. 같은 PTT에서도 Cerebras는 잔여 PCM 전송과 final 전사를 기다리고, OpenAI는 WebRTC 오디오 전달과 별도의 commit 요청을 맞춰야 합니다. 버튼 조작을 맞춘 뒤에도 연결 준비·전송·재생 버퍼의 차이는 남습니다.
브라우저의 기다림과 서버 처리 시간을 연결합니다
tracing은 한 요청이 거친 처리 구간과 이벤트를 연결해 살펴보는 방법입니다. OpenTelemetry로 수집한 서버·브라우저 기록을 같은 turn ID로 묶고 LangSmith에서 확인하도록 구성했습니다. 브라우저 지연은 performance.now()로 계산해 별도 수치로 남깁니다. 서버가 이벤트를 받은 시각으로 만든 trace의 기본 구간 길이 대신 이 수치를 읽습니다.
| 지표 | 확인하는 구간 | 해석할 때 구분할 것 |
|---|---|---|
| 연결 준비·STT 확정 | 마이크 준비, 버튼 release → final 전사 수신 | 연결 준비 시간과 final 대기를 나눕니다. 첫 임시 전사(partial)는 확정 전사가 아닙니다. |
| Main·Speech Text | 첫 text token과 각 호출의 전체 생성 시간 | 첫 token이 나와도 최종 답변과 발화문이 완성돼야 TTS로 넘어갑니다. |
| TTS 첫 오디오 | TTS 시작 → 첫 오디오 청크 수신 | 브라우저 전송·버퍼·재생 시작은 뒤에 남습니다. |
| 첫 출력 신호 | 모드별 시작점 → 브라우저 RMS 기준 통과 | 답변 재생 완료와 provider의 생성 완료는 별도 사건입니다. |
03
어떤 턴을 집계하고 비용은 어떻게 계산합니까?
대표 지연과 턴당 평균 비용에는 서버 처리가 성공하고, 중단되지 않았으며, 첫 출력 신호가 기록된 턴을 넣었습니다. 서버가 성공으로 끝나도 브라우저 재생을 멈춘 턴은 중단으로 분류합니다. 전체 시도 수와 출력 신호 수, 중단 수를 따로 남겨 대표 표본에서 빠진 기록도 볼 수 있게 했습니다.
비용은 사용량에 당시 적용한 단가를 곱한 USD 추정치입니다. Cerebras는 Main과 Speech Text의 호출을 모두 합산하고 STT·TTS 비용을 더합니다. Realtime은 text·audio 입력과 출력을 나누며, 입력에 포함된 cached token에는 캐시 단가를 적용합니다. 아래 단가는 2026년 9월 6일 기록을 검산한 기준이며 실제 청구액과 대조한 금액은 아닙니다.
| 항목 | 당시 적용 단가 | 계산에 사용한 양 |
|---|---|---|
| Cerebras gpt-oss-120b | 100만 token당 입력 $0.35 · 출력 $0.75 | Main + Speech Text의 입력·출력 token |
| Scribe v2 Realtime | 시간당 $0.39 | 당시 capture 시간 추정치 |
| ElevenLabs Flash/Turbo TTS | 1,000자당 $0.05 | TTS에 보낸 발화문 문자 수 |
| gpt-realtime text | 100만 token당 입력 $4 · 출력 $16 · 캐시 입력 $0.40 | text 입력·출력·cache usage |
| gpt-realtime audio | 100만 token당 입력 $32 · 출력 $64 · 캐시 입력 $0.40 | audio 입력·출력·cache usage |
전체 실행 비용에는 사용량이 확인된 중단·오류 턴도 포함하고, 같은 turn ID는 한 번만 합산합니다. 총비용이 없으면 0으로 바꾸지 않고 미산정 건수를 남깁니다. 확인한 일부 비용만 있으면 부분 합으로 표시합니다. 초기 44턴의 LangSmith 기본 total_cost 필드는 모두 null이었고, 실제 검산에는 별도로 기록한 cost_total_usd와 구성 비용을 사용했습니다. 취소된 OpenAI 2턴의 비용 0은 공급자가 명시적으로 반환한 usage 0에 근거합니다.
초기 STT 비용에 사용한 capture_duration_ms는 trace에 보존되지 않았습니다. 연결 준비가 포함될 수 있는 당시 시간 추정치와 공급자의 청구 오디오 시간을 독립적으로 대조할 수 없다는 제한이 있습니다. STT 연결은 23건이었지만 Agent까지 제출된 턴은 20개였으므로, 아래 턴 비용 합계와 전체 세션 청구 총액도 다릅니다.
04
수정 전 초기 44턴에서는 무엇이 보였습니까?
2026년 9월 6일 21:02:54–21:18:19 KST의 사용자 기록입니다. 이전 개발 검증 18개 root trace와 분리한 44턴이며 C-PTT와 O-VAD가 각각 3개 세션에 있습니다. 저장한 trace와 턴별 JSON·CSV를 대조해 아래 수치를 확인했습니다.
이 기록은 STT 종료 처리 수정 전입니다. C-PTT는 버튼 release, O-VAD는 브라우저의 speech_stopped 수신에서 시간을 쟀습니다. O-VAD의 500 ms 침묵 대기와 이벤트 수신 전 구간은 제외됩니다. 같은 대본을 주고받았다는 대응 관계와 case ID가 없어, 서로 다른 질문·출력 길이와 시작점을 포함한 초기 관측으로 읽어야 합니다.
| 지표 · 집계 대상 | Cerebras cascade · C-PTT | OpenAI gpt-realtime · O-VAD |
|---|---|---|
| 전체 턴 / 세션 | 20턴 / 3세션 | 24턴 / 3세션 |
| 대표 표본 · 성공·중단 없음·출력 신호 있음 | 19턴 | 18턴 |
| 첫 출력 신호가 기록된 턴 | 20 / 20 | 20 / 24 |
| 중단한 턴 | 1턴 | 6턴 |
| 대표 표본 첫 출력 지연 · 중앙값 | 1,293 ms | 421.55 ms |
| 대표 표본 첫 출력 지연 · 평균 | 1,418.47 ms | 429.60 ms |
| 대표 표본 첫 출력 지연 · 범위 | 1,102.5–3,004.5 ms | 366.9–516.7 ms |
| 대표 표본 턴당 추정 비용 · 평균 | $0.006033 | $0.021513 |
| 전체 턴의 기록된 추정 비용 · 중단 포함 합계 | $0.122526 | $0.434043 |
| 지연 시작점 | 버튼 release | speech_stopped 이벤트 수신 |
대표 표본의 첫 출력 지연 분포
점 = 1턴 · 세로선 = 중앙값 · 가로축 = 지연(ms)
버튼 release → 첫 출력 신호
speech_stopped 수신 → 첫 출력 신호
대표 표본에서 O-VAD는 종료 이벤트 수신 뒤 첫 출력 신호까지 366.9–516.7 ms에 모였고, C-PTT는 버튼을 놓은 뒤 1,102.5–3,004.5 ms에 분포했습니다. 초기 C-PTT는 마지막 final 전사를 기다리지 않고 제출하던 시점의 구현입니다. 현재 final 대기를 포함하는 구현의 지연을 확인하려면 수정 후 기록을 따로 모아야 합니다.
O-VAD 중단 6턴 중 5턴은 공급자 응답이 취소됐습니다. 이 가운데 4턴은 출력 신호 전에, 1턴은 출력이 시작된 뒤 취소됐습니다. 나머지 1턴은 공급자 생성 완료 후 브라우저 재생을 중단한 경우입니다. C-PTT의 중단 1턴도 서버 상태는 성공이었습니다. 따라서 서버 성공 여부만으로 대표 표본을 고르면 중단된 재생이 섞입니다.
LLM 단가와 전체 음성 비용은 얼마나 달랐습니까?
| 구성 | 사용량 기준 | 20턴 비용 합계 |
|---|---|---|
| LLM | Main + Speech Text, 총 40회 호출 | $0.01379125 |
| STT | 당시 capture 시간 추정치 | $0.0244851642 |
| TTS | 합성 요청에 보낸 문자 수 | $0.084250 |
이 기록의 STT와 TTS 비용은 합계의 약 88.7%였습니다. LLM의 token 단가가 낮아도 음성 입출력 비용을 더해야 전체 경로의 비용을 판단할 수 있습니다. Realtime의 text·audio·cache usage와 Cerebras의 두 LLM 호출 및 TTS 문자 수는 저장된 사용량으로 다시 계산해 집계와 일치하는지 확인했습니다. STT 시간의 독립 검산 제한은 그대로 남습니다.
발화문을 정리하는 Speech Text 구간도 따로 측정했습니다. C-PTT 대표 19턴에서 이 호출의 전체 실행 시간 중앙값은 399.85 ms, 범위는 313.18–531.79 ms였습니다. 이는 정제를 실행한 구간의 관측값입니다. 정제를 생략하면 TTS에 보내는 문자와 내용도 달라지므로, 이 시간을 전체 지연에서 빼서 생략 경로의 결과를 만들 수는 없습니다.
입력 종료 수정의 검증은 별도로 읽습니다
초기 기록을 조사한 뒤에는 잔여 PCM 전송과 final 전사 수신을 보장하도록 STT 종료 처리를 수정했습니다. 당시 frontend 23개·backend 21개 테스트, 두 합성 음성의 Scribe 계약 검증, mock 브라우저 검증 기록이 있습니다. 이 자료는 입력 종료와 취소·timeout·usage 보존 같은 동작을 확인한 근거이며, 위 사용자 44턴이나 같은 대본의 지연·비용 비교 결과에 합치지 않았습니다.
초기 입력 음성 원본과 전사 본문이 없어 인식 정확도나 실제 말끝 유실량은 계산할 수 없습니다. 두 합성 입력의 final 수신도 사용자 음성의 인식 품질 점수로 바꾸지 않았습니다.
05
다음 비교에서는 어떤 조건을 맞춥니까?
다음 비교의 첫 단계는 수정한 C-PTT와 O-PTT에 같은 대본을 주고, 버튼 release부터 첫 출력 신호까지 재는 것입니다. L01–L06은 준비된 대본과 기록 양식이며 실행 결과는 아직 없습니다. O-VAD에 같은 대본을 쓰더라도 종료 이벤트 기준의 지연은 PTT와 분리해 집계합니다.
| 대본 | 입력·요청 출력 | 확인할 항목 |
|---|---|---|
| L01 | 짧은 입력 · 1문장 응원 | 기본 첫 출력 지연과 턴 비용 |
| L02 | 짧은 입력 · 6문장 응원 | 출력 길이 증가와 Speech Text·TTS 구간 |
| L03 | 긴 입력 · 1문장 응원 | 입력 길이 증가와 input usage |
| L04 | 긴 입력 · 6문장 응원 | 입력·출력이 함께 늘 때의 지연과 비용 |
| L05 | 같은 연결에서 일반 대화 10턴 · 매번 2문장 요청 | 턴별 지연·문맥·cache usage와 T1/T5/T10 누적 비용 |
| L06 | 새 연결에서 같은 짧은 발화 총 3턴 · 1문장 요청 | 연결 준비를 따로 기록한 첫 응답과 후속 응답의 차이 |
준비한 절차는 L01–L04를 두 모드에서 한 번씩 확인한 뒤 각 조합을 3회 반복하고 L05·L06을 추가하는 순서입니다. 홀수 반복은 C-PTT부터, 짝수 반복은 O-PTT부터 시작합니다. 각 케이스·모드·반복마다 새 대화로 시작하되 L05·L06 안에서는 연결과 대화 이력을 유지합니다. 첫 응답을 버리거나 별도 워밍업 질문을 넣지 않습니다.
마이크·출력 장치·브라우저·네트워크·model·voice·구현 버전을 기록하고, 실제 입력 초와 출력 token·문자량도 남길 계획입니다. 1문장·6문장은 요청 조건이므로 실제 출력량을 고정하지 않습니다. 요청보다 짧거나 긴 답도 원본 값과 함께 표시합니다. 작은 표본에서는 개별 값·중앙값·범위를 함께 보고, 완료·중단·오류·미산정 건수와 전체 확인 비용을 보관합니다.
기본 비교 뒤에 남은 구현과 실험
| 시나리오 | 비교할 조건 | 현재 준비 상태 |
|---|---|---|
| S01 · 도구 없는 기본 응답 | C-PTT/O-PTT · tools=[] · 같은 입력과 출력 길이 조건 | 비교 경로 구현됨 · 맞춘 조건의 결과 없음 |
| S02 · 도구 호출 추가 | 도구 0회 / 검색 1회 · 같은 계약과 반환 결과 · 실제 호출 수 | 공통 OpenAI 도구 연결과 대조 fixture 구현 필요 |
| S03 · 도구 지연·실패 | 같은 결과에 0/500/1,500 ms 지연 · 성공/timeout/오류 · 취소 비용 | 지연·실패를 제어하는 공통 fixture 구현 필요 |
| S04 · 발화문 정제 유무 | 같은 Main 최종 답변을 직접 TTS / Speech Text 후 TTS에 전달 | 현재는 항상 정제 실행 · 정제 생략 경로 구현 필요 |
| S05 · 입력·출력 부하 | L01–L04의 짧은/긴 입력 × 1문장/6문장 요청 | 대본과 기록 양식 준비 · 결과 없음 |
| S06 · 연결·문맥 누적 | L05 10턴 / L06 새 연결의 첫 턴과 후속 2턴 | 대본과 기록 양식 준비 · 초기 세션을 케이스에 대응시킬 수 없음 |
| S07 · 종료·중단 | 같은 Realtime의 PTT/VAD · 문장 중간 멈춤 · 답변 중 끼어들기 | 초기 사건·동작 테스트 있음 · 계획한 대본·반복의 결과 없음 |
S04에서는 Main 최종 답변을 고정하고 정제 전후의 입력 token·출력 token·TTS 문자량과 첫 출력 지연을 함께 볼 계획입니다. 추가 LLM 호출을 줄이는 이득과 표·목록을 듣기 좋은 문장으로 바꾸는 역할을 같은 입력에서 비교해야 합니다.
S07의 선택 대본은 문장 중간에 약 0.2초·1.2초 쉬는 V01과 긴 답변을 끝까지 듣거나 두 번째 문장 도중 끼어드는 V02입니다. 쉼 지시는 실제 침묵 측정값과 구분하고, 한 발화가 여러 응답으로 나뉘면 모두 같은 대본 턴에 연결합니다. 중단한 응답에 남은 usage와 새 응답의 비용을 함께 기록하며, 들은 문장 수만으로 비용을 추정하지 않습니다.
후속 실험에서는 같은 대본과 입력 종료 기준을 사용하고 실제 출력량을 함께 기록해, 빠른 LLM이 첫 음성 응답의 기다림에 얼마나 기여하는지 살펴볼 계획입니다.