앞선 글에서는 로디가 답변의 근거로 사용할 자료를 살펴봤습니다. 이번에는 그 자료를 어떻게 나누고 연결해야 상담 중 필요한 근거를 찾아 읽을 수 있을지 고민했습니다. 법령의 내용을 검색 가능한 크기로 나누는 일부터, 다른 조항과 문서로 이어지는 관계를 저장하는 일까지 함께 설계해야 했습니다.
1. 먼저, 법령을 어떤 단위로 나눌지 정했습니다
원본에는 조문 구조와 적용 조건이 함께 있었습니다
확보한 자료에서 법률은 법률별 JSON으로, 조례는 여러 조례를 묶은 별도 JSON으로 들어왔습니다. 법률은 ‘법령 → 조문 → 조문단위’, 조례는 ‘상세내용 → LawService → 조문 → 조’ 구조였습니다. 원문 안에는 조문 번호와 제목, 항·호, 부칙과 별표 같은 구분이 남아 있었습니다.
이 구조에서 중요하게 본 것은 규정과 그 규정을 제한하는 조건의 관계였습니다. 실제로 확보한 「근로자퇴직급여 보장법」 제4조제1항에는 퇴직급여제도를 설정해야 한다는 본문과, ‘다만’으로 시작하는 적용 예외가 같은 항에 들어 있습니다. 제4항에도 의견 청취에 관한 본문과 불리한 변경에 관한 단서가 함께 있습니다.
원문 예시 · 본문과 단서를 함께 읽어야 하는 이유
근로자퇴직급여 보장법 제4조제1항
① 사용자는 퇴직하는 근로자에게 급여를 지급하기 위하여 퇴직급여제도 중 하나 이상의 제도를 설정하여야 한다. 다만, 계속근로기간이 1년 미만인 근로자, 4주간을 평균하여 1주간의 소정근로시간이 15시간 미만인 근로자에 대하여는 그러하지 아니하다.
설정 의무와 적용 예외가 같은 항 안에 있습니다. 본문만 검색되면 계속근로기간과 근로시간에 따른 예외를 확인하기 어렵습니다.
근로자퇴직급여 보장법 제4조제4항
④ 사용자가 제3항에 따라 설정되거나 변경된 퇴직급여제도의 내용을 변경하려는 경우에는 근로자대표의 의견을 들어야 한다. 다만, 근로자에게 불리하게 변경하려는 경우에는 근로자대표의 동의를 받아야 한다.
일반적인 변경에는 의견 청취를 요구하지만, 불리한 변경에는 동의를 요구합니다. 앞 문장과 단서를 함께 읽어야 요건의 차이를 구분할 수 있습니다.
검색 결과가 본문만 포함하고 예외를 놓치면 답변의 의미가 달라질 수 있습니다. 그래서 chunk의 크기와 함께 어떤 문장들을 한 덩어리로 읽어야 하는지를 기준으로 삼았습니다. 나눈 chunk 사이의 관계는 2절에서, 이 관계를 탐색하는 절차와 Agent에게 맡길 판단은 3절에서 설명합니다.
원본 사례: 퇴직급여법 JSON · 제4조의 본문과 단서
고정 길이와 overlap, 의미 단위를 비교했습니다
고정 길이로 나누고 앞뒤 일부를 겹치게 하는 방식은 단순하고 처리량을 예측하기 쉽습니다. Overlap은 경계에 걸친 내용을 양쪽 청크에 남겨 단절을 완화합니다. 다만 조항마다 길이가 다르고 조건이 여러 항에 걸칠 수 있어, 정해진 중복 범위가 필요한 문맥을 항상 담지는 못합니다. 범위를 늘리면 중복으로 저장하고 읽는 내용도 늘어납니다.
참고 자료 · 문서 구조와 질문에 맞는 경계
Microsoft Azure AI Search는 고정 크기·overlap과 함께 문장·제목·문서 구조를 활용한 분할을 설명합니다. Overlap은 인접 chunk의 문맥을 이어주는 수단이며, 적절한 크기는 자료의 구조와 질문에 따라 조정해야 합니다. 로디에서는 법령의 본문과 단서가 같은 해석 단위라는 점을 경계 선택에 적용했습니다.
참고: Microsoft — Chunk documents / Document Layout 기반 chunking
NVIDIA는 다섯 데이터셋에서 token·page·section 단위 분할을 비교했습니다. 같은 금융 문서에서도 가장 나은 방식과 크기가 달랐으며, 실제 문서와 질문으로 여러 경계를 평가하도록 권합니다. 로디의 선택 근거는 아래 법령 원문에서 확인한 구조이며, 이 외부 실험은 그 선택을 검토할 참고 자료로 사용합니다.
참고: NVIDIA — Finding the Best Chunking Strategy for Accurate AI Responses
로디에서는 법령의 구조와 의미를 보고 경계를 정하는 쪽을 선택했습니다. 일정한 길이를 맞추는 것보다 함께 해석해야 하는 규정과 조건을 보존하려는 판단이었습니다. 선택지를 비교하면 다음과 같습니다.
아래 표는 실제 API 원본의 제4조 제목과 네 항을 줄바꿈으로 이어 붙인 같은 텍스트를 사용합니다. 고정 길이는 120자, overlap은 24자로 두어 경계를 눈으로 비교합니다. 이는 설명용 설정이며 실제 pipeline의 설정값이 아닙니다. “…”는 표시할 때만 생략한 중간 부분입니다.
| 방식 | 장점 | 경계 비교 · 앞 chunk 끝 ↔ 뒤 chunk 시작 |
|---|---|---|
| 고정 길이 + overlap | 길이와 처리량을 예측하기 쉽고 인접 문맥 일부를 중복해 남깁니다. | 앞 chunk 끝: “…계속근로기간이 1년 미만인 근로자, 4주간을 평균하여 1주간의 소정근로”뒤 chunk 시작: “근로자, 4주간을 평균하여 1주간의 소정근로시간이 15시간 미만인 근로자에 대하여는 그러하지 아니하다.…”겹친 24자: “근로자, 4주간을 평균하여 1주간의 소정근로”. 앞쪽은 ‘소정근로|시간’ 사이에서 끊기고, 뒤쪽에는 설정 의무와 1년 미만 예외가 빠집니다. |
| 조·항·호 규칙 | 조문·항 경계가 명시된 JSON에서 같은 규칙으로 분할 결과를 재현할 수 있습니다. | 앞 chunk 끝: “…15시간 미만인 근로자에 대하여는 그러하지 아니하다.”뒤 chunk 시작: “② 제1항에 따라 퇴직급여제도를 설정하는 경우에…”이 조문에서는 문장과 항의 경계가 맞고 본문·단서가 함께 남습니다. 뒤 chunk의 ‘제1항’은 앞 항을 참조하므로 연결이 필요합니다. |
| 의미·구조 단위 | 규정과 조건·예외가 함께 해석되도록 경계를 정합니다. | 앞 chunk 끝: “…15시간 미만인 근로자에 대하여는 그러하지 아니하다.”뒤 chunk 시작: “② 제1항에 따라 퇴직급여제도를 설정하는 경우에…”이 조문에서는 항 단위 분할과 같은 경계를 택해 규정·조건·예외를 함께 둡니다. 다른 자료에서도 함께 읽어야 할 의미가 갈라지는지를 봅니다. |
overlap은 앞 chunk의 끝부분을 뒤 chunk에도 포함해 경계 주변의 문맥을 공유하도록 하는 방식입니다. 일부 내용이 양쪽에 겹쳐 남으므로, 경계 가까이에 있는 정보가 검색되었을 때 주변 내용을 이해할 단서도 함께 가져올 수 있습니다. 겹치는 길이는 함께 읽어야 할 문맥의 범위에 맞춰 정해야 하며, 위 예시처럼 고정된 24자만으로는 규정과 예외를 모두 담기 어려운 경우가 있습니다.
조·항·호를 따르는 rule-based chunking도 문서마다 같은 규칙을 그대로 적용하기는 어렵습니다. 여러 호가 앞 문장의 공통 조건을 공유하거나 조건·예외가 다른 항에 이어지는 경우에는 번호만 기준으로 나누면 필요한 문맥이 갈라질 수 있습니다. 이런 구조에 맞추려면 관련 내용을 함께 묶거나 분리하는 규칙을 추가해야 합니다.
입력 데이터의 종류와 형식에 따라서도 추가 parsing logic이나 전처리가 필요할 수 있습니다. 확보한 법률과 조례도 JSON 계층이 달라 조문·항·호를 읽어내는 경로를 각각 처리해야 합니다. 같은 내용을 PDF나 일반 텍스트로 받는다면 조문 번호와 줄바꿈을 정리하고 표·별표의 구조를 복원하는 과정이 필요할 수 있습니다. 자료가 늘어날 때는 기존 규칙이 새 형식에서도 필요한 문맥을 보존하는지 확인하고 조정해야 합니다.
이 비교에서 선택한 기준은 규정·조건·예외를 함께 보존하는 의미 단위입니다. 경계를 LLM이 판단하도록 만든 구현은 RAG 04의 Construction pipeline에서 설명합니다.
2. 나눈 chunk 사이의 참조 관계도 보존해야 했습니다
서로 다른 조항과 파일로 이어지는 참조가 있었습니다
조건을 같은 청크에 보존해도, 멀리 떨어진 다른 조항이나 별도 법률에 있는 정의까지 모두 담을 수는 없습니다. 확보한 「근로자퇴직급여 보장법」 제8조는 퇴직금에 관한 규정에서 ‘평균임금’을 사용합니다. 같은 법 제2조제4호는 그 정의를 「근로기준법」 제2조제1항제6호로 연결합니다.
퇴직급여법 제8조 → 같은 법 제2조제4호 → 근로기준법 제2조제1항제6호
조례에도 같은 구조가 있습니다. 「울산광역시 고령자 경비원의 고용 안정 조례」 제2조는 ‘사용자’의 정의를 「근로기준법」 제2조제1항제2호에서 가져옵니다. 실제 입력 자료에서도 조례와 근로기준법은 별도 파일입니다. 파일을 각각 청킹하는 것만으로는 이 참조 관계가 검색 경로로 만들어지지 않습니다.
원문 예시 · 별도 조항과 파일을 잇는 참조
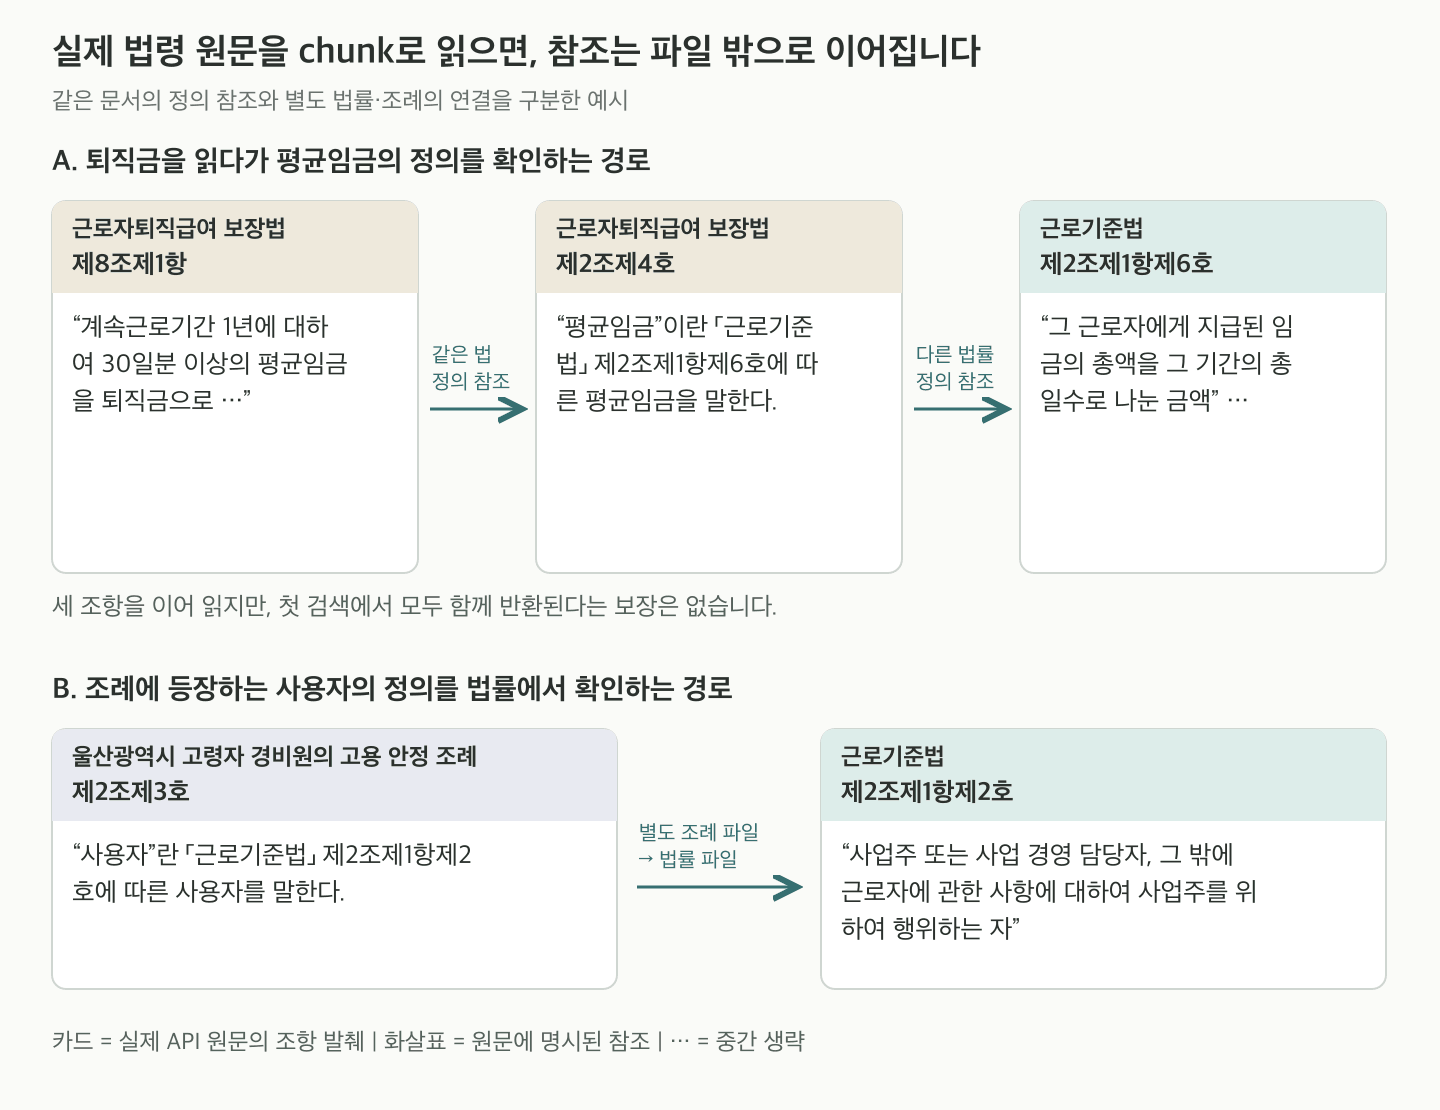
그림은 실제 법령 원문을 설명용 chunk로 나누고, 문구가 가리키는 정의를 연결한 것입니다. 같은 법의 다른 조항과 별도 법률·조례 파일로 이어지는 참조를 구분했습니다. 각 chunk의 내용과 함께 어떤 chunk를 참조하는지도 데이터 구조에 남겨, 관련 근거를 함께 찾아 읽도록 만들고자 했습니다.
원본 사례: 퇴직급여법 JSON / 근로기준법 JSON / 고령자 조례 JSON
자료 범위: 위 사례는 확보한 법률과 조례의 API 원본에서 가져왔습니다. 별도 판례 데이터셋은 확인되지 않아 이번 사례에 포함하지 않았습니다.
각 chunk를 node로, chunk 사이의 참조 관계를 edge로 표현하면 한 조항에서 연결된 정의나 조건을 따라갈 수 있습니다. 이렇게 연결된 데이터는 고정 workflow와 Agentic RAG가 함께 사용할 수 있는 검색 기반입니다. 다음 절에서는 이 관계를 어느 순서와 범위로 탐색해 답변의 context를 구성할지 살펴봅니다.
3. 근거를 언제 가져와 사용할지 Agent에게 맡기려 했습니다
로디에서는 상담 중 필요한 시점에 근거를 가져와 context에 넣고, 그 근거로 답할 수 있는지 Agent가 판단하게 하려 했습니다. 질문을 받았을 때 바로 자료를 조회할지, 사용자 조건을 먼저 확인할지, 찾은 근거만으로 충분한지에 따라 다음 행동을 고르게 하는 것이 의도였습니다.
- 관련 근거 찾기: 질문과 사용자 상황에 맞는 근거가 필요할 때 검색 tool을 호출합니다.
- 부족한 정보 판단하기: 반환된 근거에서 답변에 필요한 정의나 조건을 확인합니다. 사용자 조건이 부족하면 frontend tool로 입력 양식을 제시하고, 필요한 항목을 작성해 달라고 요청할 수 있게 했습니다.[1]
- 다음 탐색 선택하기: 참조 조항을 더 읽거나 검색어를 바꾸고, 필요한 정보에 따라 RAG search와 web search를 선택합니다. 사용자 조건이 부족하면 추가로 묻습니다.
- 근거 사용과 탐색 종료 판단하기: 확보한 근거를 답변에 사용할 수 있는지 판단하고, 충분하면 탐색을 마칩니다.
사용자에게 일반적인 답변을 바로 제시하기보다, 거주지·상담 목적·현재 상황처럼 응답에 필요한 내용을 구체적으로 받아 안내하는 편이 상담 UX에 더 도움이 된다고 판단했습니다. 입력 양식에는 대화에서 이미 확인한 값을 채우고, 아직 모르는 항목을 사용자가 보완하도록 했습니다. 사용자가 입력한 값은 다음 상담 요청에 포함해, 자신의 조건에 맞는 선택지와 다음 행동을 안내받도록 연결했습니다.
[1] 입력 양식을 여는 frontend tool은 Screen Control Agent에 제공했습니다. 어떤 상황에서 UI를 바꾸고, 양식의 필드와 입력값을 어떻게 전달하는지는 후속 상담 Agent 3 · 화면 변경 편에서 자세히 다룹니다. 본문으로 돌아가기
설계 참고: Rahmani et al. (2024), Clarifying the Path to User Satisfaction은 Bing 기반 MIMICS·MIMICS-Duo 분석에서 막연히 요구를 다시 묻기보다 구체적인 의도를 확인하는 질문이 더 유용하게 평가됐다고 보고했습니다. Microsoft HAX의 Disambiguate before acting도 사용자 의도가 불명확할 때 먼저 확인하도록 권합니다. 답변에 필요한 조건을 구체적인 입력 항목으로 요청하는 로디의 설계를 검토할 때 참고할 수 있는 자료입니다.
법률 근거와 웹 정보를 필요한 시점에 함께 쓰려 했습니다
저장된 법률정보를 찾는 RAG search와 실제 사례·기관 안내·현재 공고를 확인하는 web search를 함께 주고 싶었습니다. 예를 들어 울산의 고령자 경비원 상담에서는 조례와 근로기준법으로 정의와 적용 근거를 확인하고, 상담소의 실제 운영 여부나 연락처·현재 안내는 웹에서 찾는 식입니다. 웹에서 얻은 단서로 다시 관련 조항을 조회하는 역방향도 필요합니다.
두 tool을 사용할 수 있게 제공하고, 상담 중 어떤 정보가 필요한지에 따라 Agent가 호출 시점과 순서를 선택하게 하려 했습니다. 각 tool이 반환한 근거를 context에 추가한 뒤, 답변에 사용하거나 다음 조회의 단서로 삼도록 구성하려는 의도였습니다.
Vanilla RAG와 Agentic RAG · 근거 주입과 사용 시점
여기서 비교 대상으로 삼은 Vanilla RAG는 매 응답 전에 정해진 retrieval 절차를 실행하고, 검색한 근거를 context에 넣어 답변하는 구성입니다. Agentic RAG에서는 Agent가 대화와 현재 근거를 보고 검색이 필요한 시점에 tool을 호출하며, 반환된 내용을 반영해 다음 행동을 정합니다. 로디에서는 근거를 가져오는 시점과 대상을 판단하는 일까지 Agent에게 맡기려 했습니다.
매 응답 전에 retrieval을 실행하면 인사나 사용법 안내, 사용자가 조건을 보완하는 대화에도 검색 결과가 추가됩니다. 아직 어떤 정책을 확인할지 정하지 못한 상황에서는 관련성이 낮은 조항까지 context에 들어올 수 있습니다. 이런 내용은 읽어야 할 분량과 처리 비용을 늘리고, 사용자의 상황과 무관한 조건을 답변에 섞는 noise가 될 수 있다고 보았습니다.
정책을 확인하는 질문에서도 몇 개의 chunk를 넣을지 정해야 합니다. 조항을 나누어 저장하면 한 질문에 본문·정의·예외가 함께 필요할 수 있는데, 고정된 top-K 안에 이들이 모두 들어온다는 보장은 없습니다. K를 늘리면 필요한 근거를 더 담을 여지가 생기지만 무관한 조항도 함께 늘 수 있습니다. 따라서 검색이 필요한지와, 검색한 근거가 답변에 충분한지를 따로 판단하게 하려 했습니다.
설계 참고: Self-RAG (Asai et al., 2023)도 검색 필요성과 문서의 관련성을 고려하지 않고 일정 수의 문서를 주입할 때 생기는 문제를 다룹니다. 로디에서는 이 문제를 검토하는 참고 자료로 사용합니다.
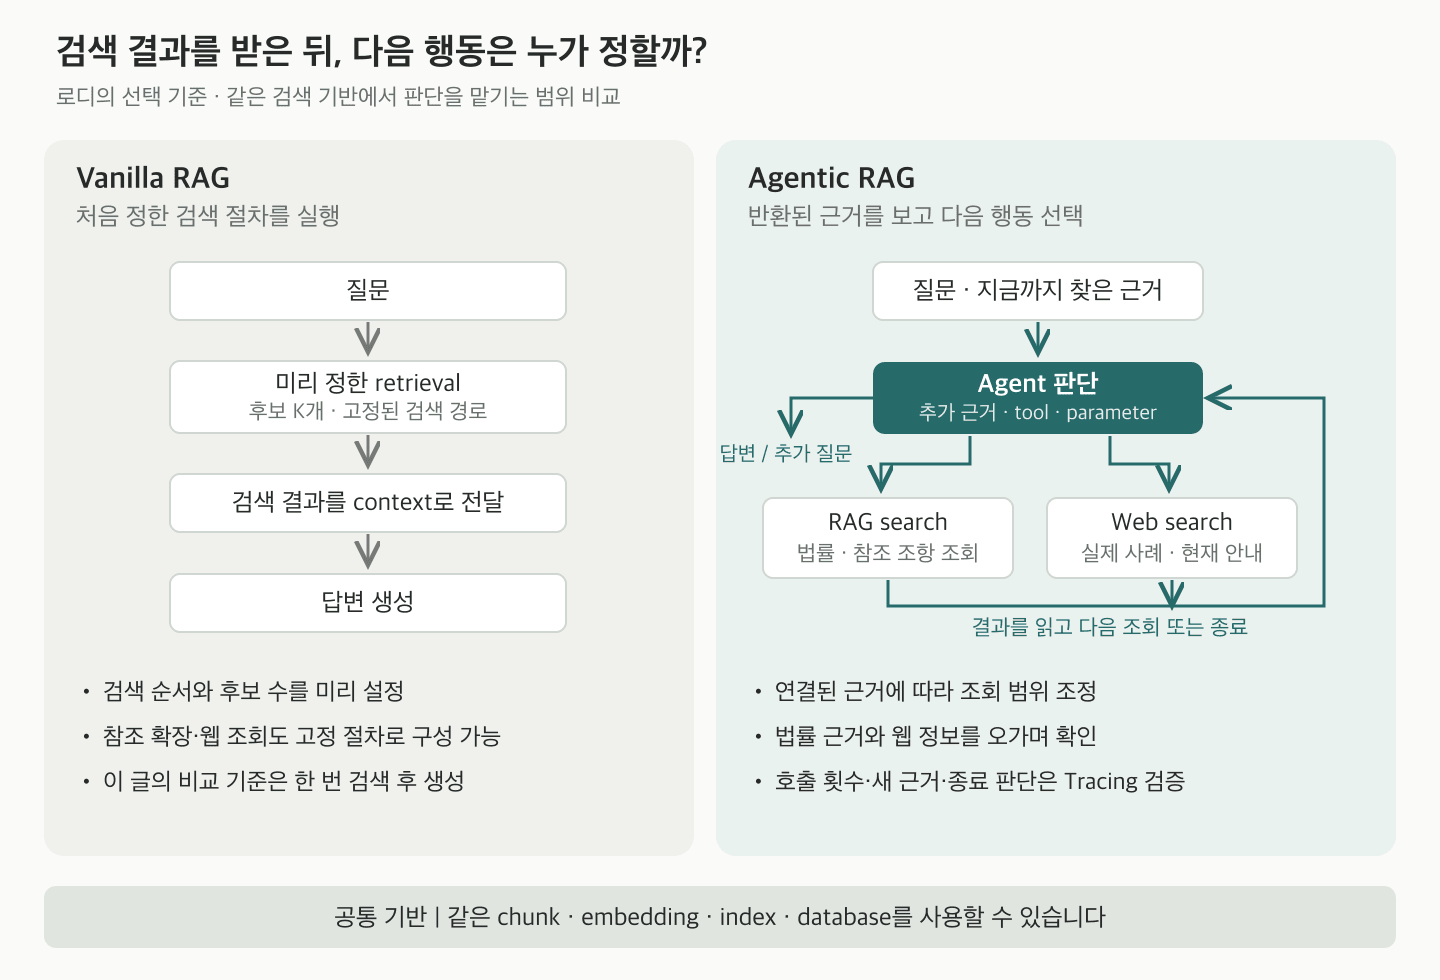
앞 절의 graph는 두 방식에서 공통으로 사용할 수 있습니다. Entry point를 찾고 주변 node를 정해진 수만큼 모아 한 번에 context에 넣는 절차도 가능합니다. 검색을 생략하는 분기나 query rewriting을 고정 workflow에 추가할 수도 있습니다. 로디에서 Agent에게 맡기려던 판단은 현재 대화와 반환된 근거를 보고 조회 대상·추가 질문·탐색 종료를 선택하는 부분입니다.
첫 검색의 top-K 후보 수, graph의 확장 node 수와 hop 깊이, context에 담을 분량은 각각 정해야 합니다. Agentic RAG에서도 각 tool의 반환 범위와 전체 호출 한도는 필요합니다.
참고: LangChain의 2-Step RAG와 Agentic RAG 구분 / Neo4j의 vector search·graph traversal 결합 예시
일상적인 표현에서 탐색의 시작 node를 찾는 문제
로디의 사용자는 정확한 정책 이름이나 법률의 몇 조 몇 항이 필요한지 모른 채 자신의 상황을 설명할 것으로 보았습니다. 사용자의 일상적인 표현과 법령에 쓰인 용어 사이의 차이 때문에, 입력을 그대로 검색하면 필요한 조항으로 이어지는 시작 node를 놓칠 수 있다는 가설로 프로젝트를 진행했습니다. 관련 조항이 graph로 연결돼 있어도, 그 관계를 따라갈 출발점을 먼저 찾아야 합니다.
Agent에게 검색을 맡겼을 때에는 사용자 문장을 그대로 전달하기보다, intent를 해석해 관련 개념과 여러 candidate keyword로 검색을 시도하는 패턴을 보았습니다. 이 과정은 일반적인 상황 설명에서 정책·법률 용어를 찾아 시작 node 후보를 좁히는 역할을 합니다. 이후에는 찾은 node의 참조 관계를 따라 필요한 정의와 조건을 읽도록 의도했습니다.
그러나 후보 keyword를 만드는 과정에서도 적절한 법률 개념을 놓치거나 다른 제도를 선택할 수 있습니다. 사용자가 정확한 법률·조항을 지정한 질문과 달리, 일상적인 표현만 있는 질문은 검색할 핵심 단어를 찾는 단계부터 어렵습니다. Vector search를 사용하더라도 후보 검색어와 embedding이 필요한 조항에 도달하는 데 도움이 되는지 확인해야 합니다. 현재 구현은 자연어 keyword에 text search를 먼저 사용하고, vector search는 별도 embedding 입력을 받으므로 두 검색 경로를 구분해 평가해야 합니다.
설계 참고: Query Rewriting in Retrieval-Augmented Large Language Models (Ma et al., 2023)은 사용자 입력과 검색에 필요한 지식 사이의 차이를 query rewriting으로 다룹니다. 후속 실험에는 고정된 rewriting 단계도 비교 대상으로 넣어 검색어 변경과 Agent의 탐색 판단이 미치는 영향을 나눠 볼 계획입니다.
결론 · 근거를 보존하고, 필요한 시점에 찾아 읽도록
로디에서는 규정·조건·예외를 함께 읽을 수 있도록 chunk의 경계를 정하고, 다른 조항을 참조하는 관계를 graph에 남기려 했습니다. 이 데이터 위에서 Agent가 상담에 필요한 근거를 찾고, 부족한 사용자 조건을 확인하며, 확보한 근거로 답할 시점을 판단하도록 설계했습니다.
남은 검증은 일반적인 표현으로 질문해도 필요한 조항에 도달하는지입니다. 후속 실험에서는 일상어 질문과 법률·조항을 명시한 질문을 나누고, 원문 검색·고정 query rewriting·Agent의 후보 keyword 검색을 같은 조건에서 비교할 계획입니다. 시작 node를 찾는 성능과 graph를 따라 필요한 근거를 확보하는 성능을 나눠 측정하고, 실제 tool 사용 흐름은 RAG 03의 MCP integration과 Tracing에서 함께 확인하겠습니다.