“일을 그만뒀는데 받을 수 있는 돈이 있나요?”처럼 묻는 사람은 어떤 제도나 조항을 찾아야 할지 모를 수 있습니다. 고령층을 위한 복지 상담 서비스 로디는 이런 상황 설명에서 관련 근거를 찾고, 적용 조건이 부족하면 다시 묻는 대화를 목표로 했습니다.
법령을 검색해 비슷한 문장을 찾는 것만으로는 부족했습니다. 찾은 조항이 다른 곳의 정의를 참조하거나 예외 조건을 두었다면 함께 읽어야 합니다. 저는 팀 프로젝트에서 상담 Agent가 저장된 법령·조례를 조회하는 RAG MCP를 구현했습니다. 이 글은 첫 후보를 찾은 뒤 같은 근거의 ID로 다음 조회를 이어가도록 저장 구조와 도구를 연결한 과정을 설명합니다.
여기서 Chunk는 함께 읽을 원문을 묶은 근거 단위이고, anchor는 후속 조회의 출발점으로 고른 근거입니다. MCP tool은 상담 Agent가 선택해 호출하는 조회 기능입니다. 원문을 어떤 단위로 나누고 검색이 필요한 시점을 어떻게 판단할지는 RAG 02에서 다뤘습니다.
조회 기능에는 목적을 설명하는 description과 입력 형식을 붙였습니다. Agent의 instruction에는 후보를 찾으면 그 ID로 연결된 근거를 살펴보라는 지침을 넣었습니다. 이 흐름은 Agent가 선택할 사용 방법이며, 서버가 정해진 순서로 실행하는 workflow는 아닙니다. 근거와 관계를 준비하는 구축 과정은 RAG 04에서 이어갑니다.
1. 검색 결과에서 원문과 참조로 이어지는 schema
Document는 Construction pipeline이 원문을 읽고 Chunk를 생성하기 위한 입력 node입니다. raw_content에 원문 전체를 보관하고, 파일·출처·버전 정보도 함께 둡니다. 상담에서 읽을 근거는 Chunk.text로 나누어 저장합니다. Document와 Chunk를 HAS_CHUNK로 연결하고, document_id와 chunk_index로 소속 문서와 순서를 확인하도록 했습니다.
Chunk의 id는 검색 결과를 다음 조회로 연결하는 식별자입니다. text는 원문에서 가져온 근거이며, summary·chunk_name·chunk_description은 내용을 파악하는 보조 필드입니다. Embedding과 원문 위치 marker도 같은 Chunk에 둡니다. 아래 그림은 검색에서 Chunk를 선택한 뒤 관련 Chunk를 따라 읽으려는 흐름과, 그 근거의 소속 문서를 함께 보여줍니다.
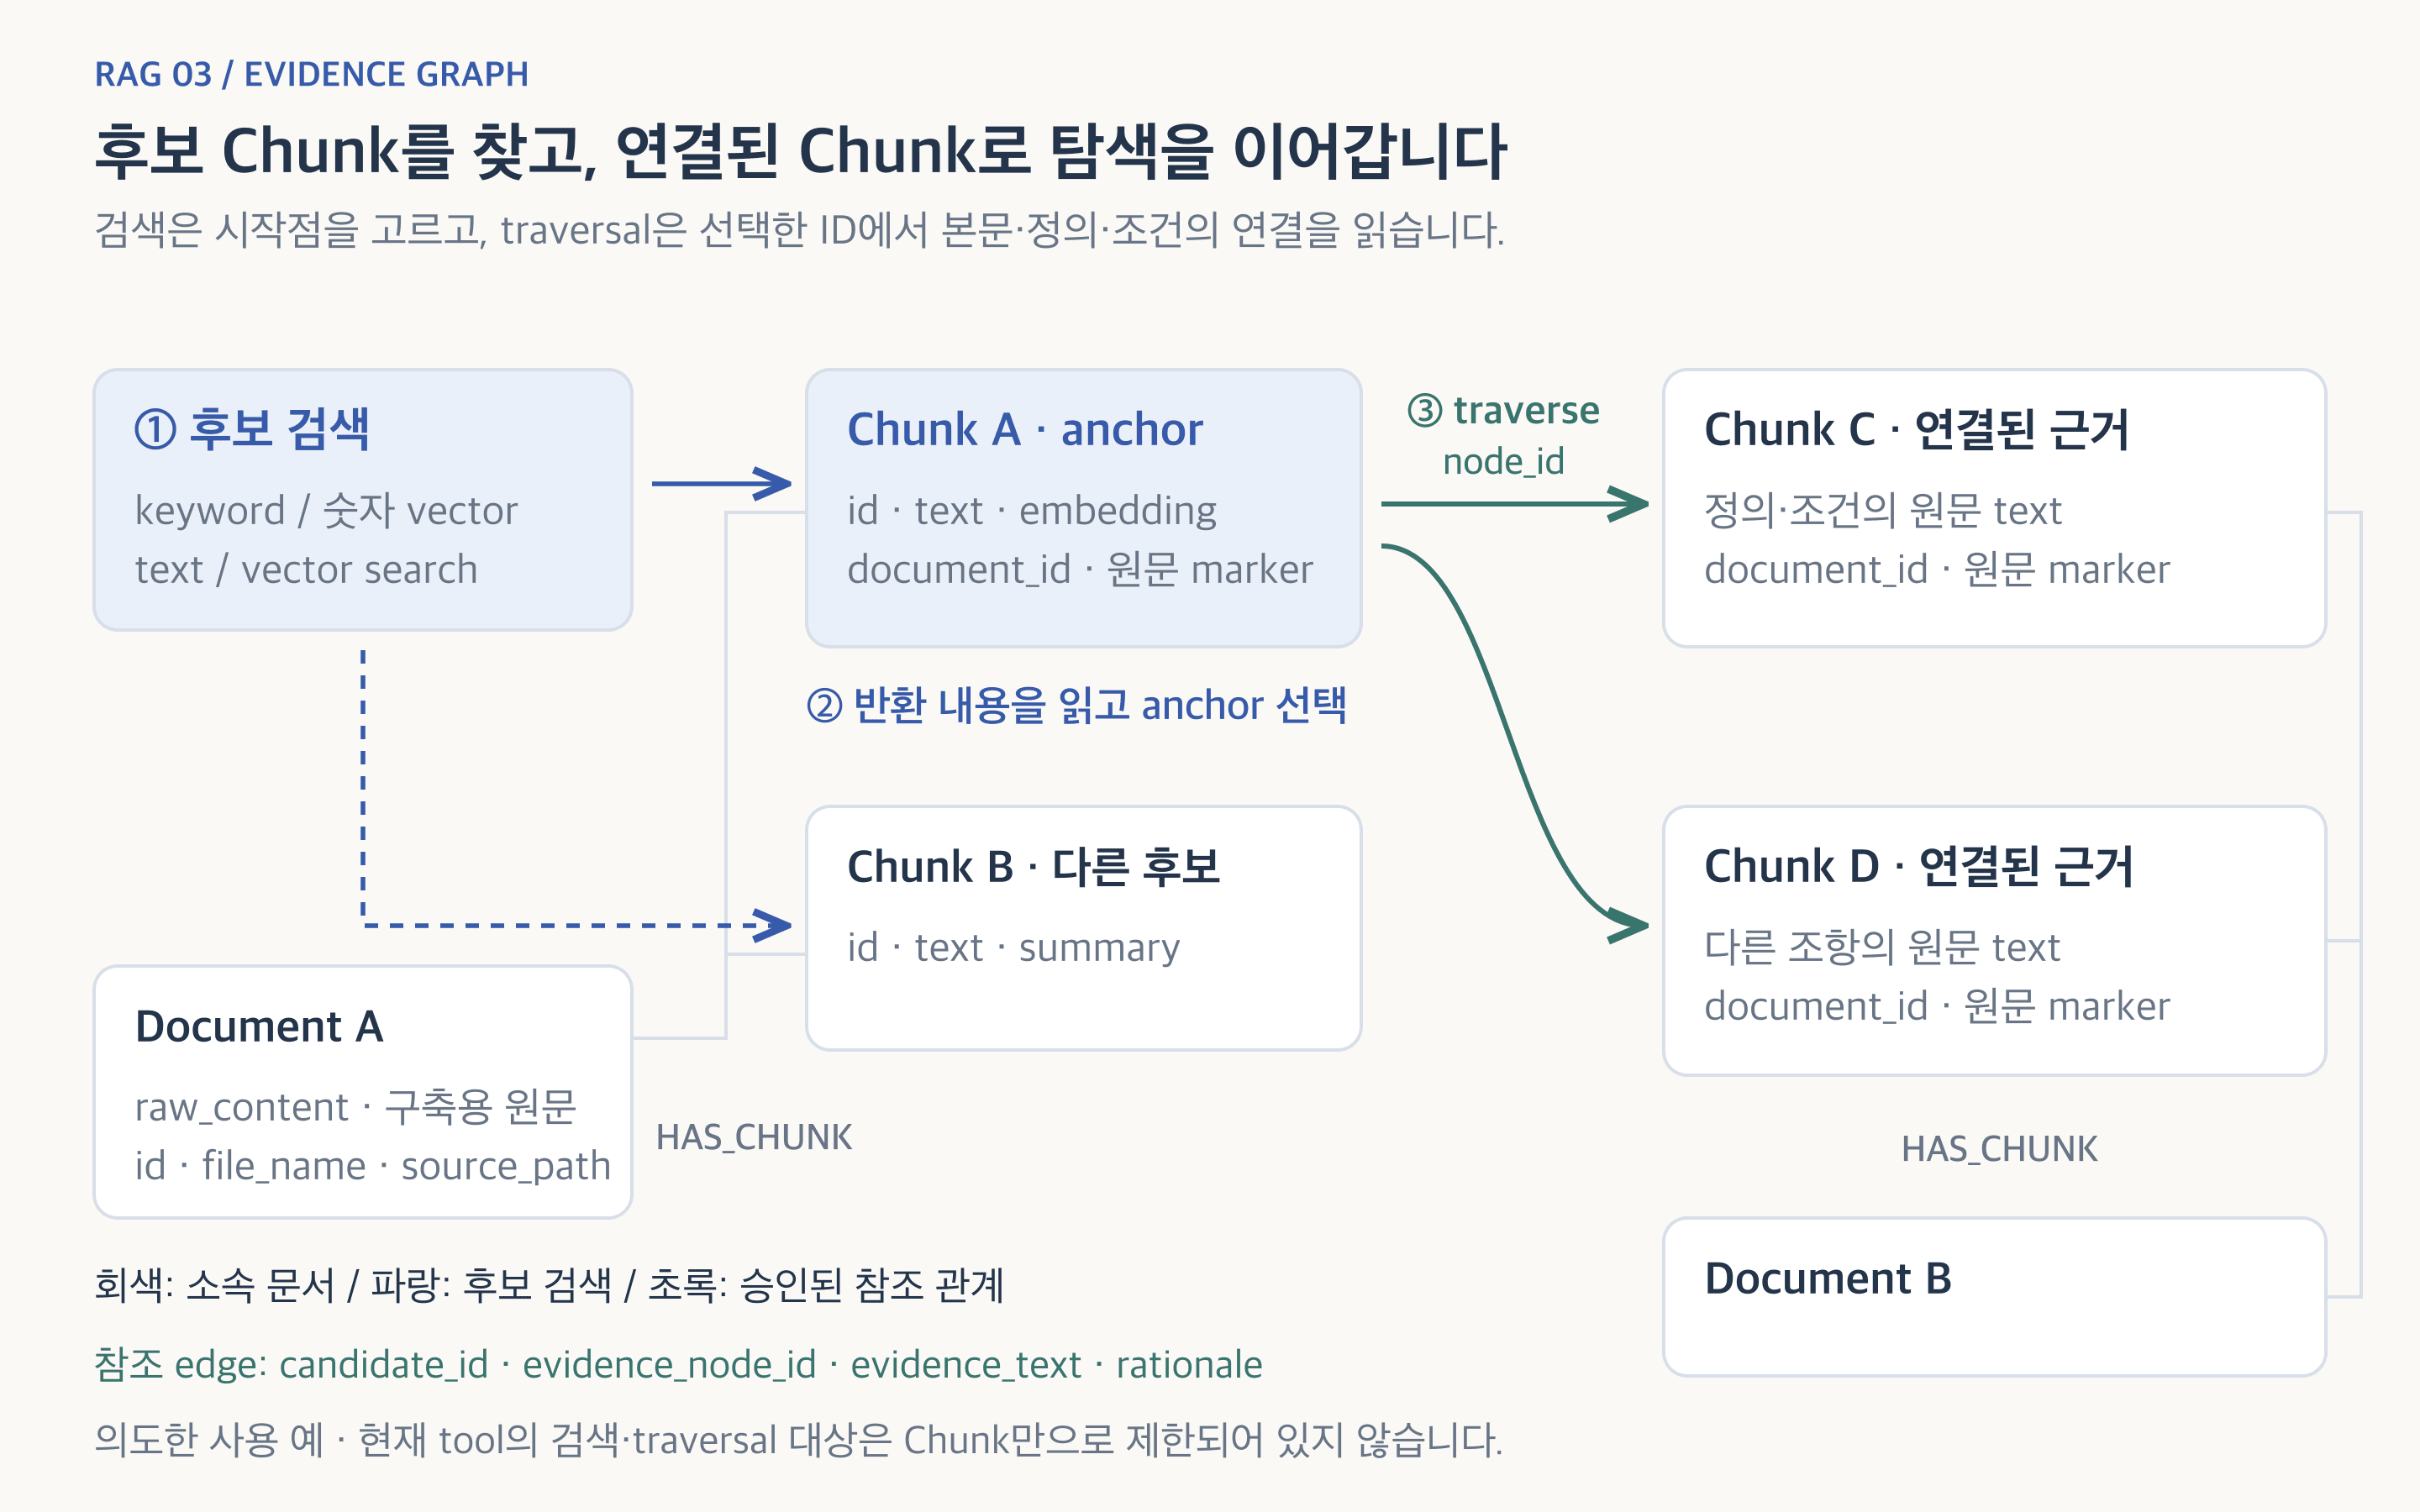
조회에서 먼저 필요한 정보는 네 가지입니다. 검색 결과가 다음 도구의 입력이 되고, 답변에서 다시 원문을 찾을 수 있도록 저장했습니다.
| 조회에 필요한 것 | 저장한 정보 | 이어지는 판단 |
|---|---|---|
| 같은 근거를 다시 찾기 | Chunk의 id | 선택한 후보를 anchor로 삼아 주변을 조회합니다. |
| 적용 조건 읽기 | text와 짧은 설명 | 질문과 관련 있는지, 더 읽을 내용이 있는지 판단합니다. |
| 원문 확인하기 | document_id, 원문 위치, Document의 출처·버전 | 어느 문서의 어느 부분인지 되짚습니다. |
| 참조 이어 읽기 | 승인된 관계와 evidence_text | 연결된 정의·조건의 원문과 연결 이유를 확인합니다. |
Document·Chunk·승인 관계의 전체 필드 보기
표는 그림에 나온 Document·Chunk·HAS_CHUNK·승인된 관계의 필드를 설명합니다. 검색·답변에 쓰는 근거 데이터와 검토·개선을 위한 기록을 나누어, 이 편에서는 근거 데이터의 구조를 다룹니다. RelationshipCandidate는 승인되면 양 끝 node 사이에 실제 edge가 만들어지고 후보 기록도 남습니다. 이 승격 절차는 RAG 04에서 설명하며, ReviewNote와 Memory의 상세 schema는 이 표에서 제외합니다.
| 저장 대상 | 필드·연결 | 역할 |
|---|---|---|
| Document | id | 문서 식별자입니다. Construction 입력과 Chunk.document_id에 사용합니다. |
| Document | raw_content | Construction에서 읽을 원문 전체입니다. 같은 이름의 필드는 Agent 응답에서 제외합니다. |
| Document | file_name | 등록한 파일 이름입니다. |
| Document | source_type | text·json·md 등 입력 자료의 종류입니다. |
| Document | source_path | 원문 출처 경로입니다. 값이 없을 수 있습니다. |
| Document | entry_number | 입력 문서에 부여한 항목 번호입니다. |
| Document | document_version | 문서 버전입니다. 기본값은 1입니다. |
| Document | content_hash | 원문 내용의 hash입니다. |
| Document | metadata | 자료별 부가 정보입니다. Agent 응답에서 제외합니다. |
| Chunk | id | 검색 결과를 graph_traverse의 node_id로 연결할 식별자입니다. |
| Chunk | document_id | 소속 Document의 id입니다. |
| Chunk | chunk_index | 문서 안에서 Chunk가 놓인 순서입니다. |
| Chunk | text | 원문에서 가져온 근거 본문입니다. Embedding 입력으로도 사용합니다. |
| Chunk | chunk_name | Chunk 내용을 나타내는 이름입니다. |
| Chunk | chunk_description | Chunk가 다루는 내용을 설명합니다. |
| Chunk | summary | 내용을 빠르게 파악하기 위한 요약입니다. |
| Chunk | tags | 내용을 분류하는 태그 목록입니다. |
| Chunk | reason | Chunk를 해당 단위로 나눈 이유입니다. |
| Chunk | start_unique_string / end_unique_string | 각각 원문에서 시작·끝 위치를 다시 찾는 문자열 marker입니다. |
| Chunk | start_char / end_char | 각각 원문 내 시작·끝 문자 위치입니다. 값이 없을 수 있습니다. |
| Chunk | embedding | Chunk.text의 숫자 vector입니다. Agent 응답에서 제외합니다. |
| Chunk | embedding_model | Vector를 만든 모델 이름입니다. |
| Chunk | embedding_status | Embedding 처리 상태입니다. 초기값은 pending입니다. |
| Chunk | metadata | Chunk별 부가 정보입니다. Agent 응답에서 제외합니다. |
| Chunk | last_ingest_job_id | Chunk를 저장한 구축 job입니다. 같은 job의 재저장 대상을 구분합니다. |
| Document·Chunk | created_at / updated_at | 저장 query에서 부여하는 생성·갱신 시각입니다. |
| 소속 관계 | Document -[:HAS_CHUNK]-> Chunk | 문서와 그 문서에서 나눈 Chunk를 연결합니다. 현재 별도 edge property는 쓰지 않습니다. |
| 승인된 관계 | 관계 type·양 끝 node | 후보의 관계 종류·대상을 실제 edge로 반영합니다. 그림은 Chunk 사이 참조의 예입니다. |
| 승인된 관계 | candidate_id | 승인된 RelationshipCandidate 기록을 가리킵니다. |
| 승인된 관계 | evidence_node_id | 관계의 근거가 있는 node의 id입니다. |
| 승인된 관계 | evidence_text | 연결을 뒷받침하는 원문 발췌입니다. |
| 승인된 관계 | rationale | 두 근거를 연결한 이유입니다. |
| 승인된 관계 | relationship_direction | 후보에서 정한 방향입니다. 양방향이면 두 방향의 edge를 만듭니다. |
| 승인된 관계 | materialized_by | 관계 승인을 처리한 검토자입니다. |
| 승인된 관계 | materialized_at | 실제 edge에 반영한 시각입니다. |
검색 시작점과 tool에 공개하는 데이터
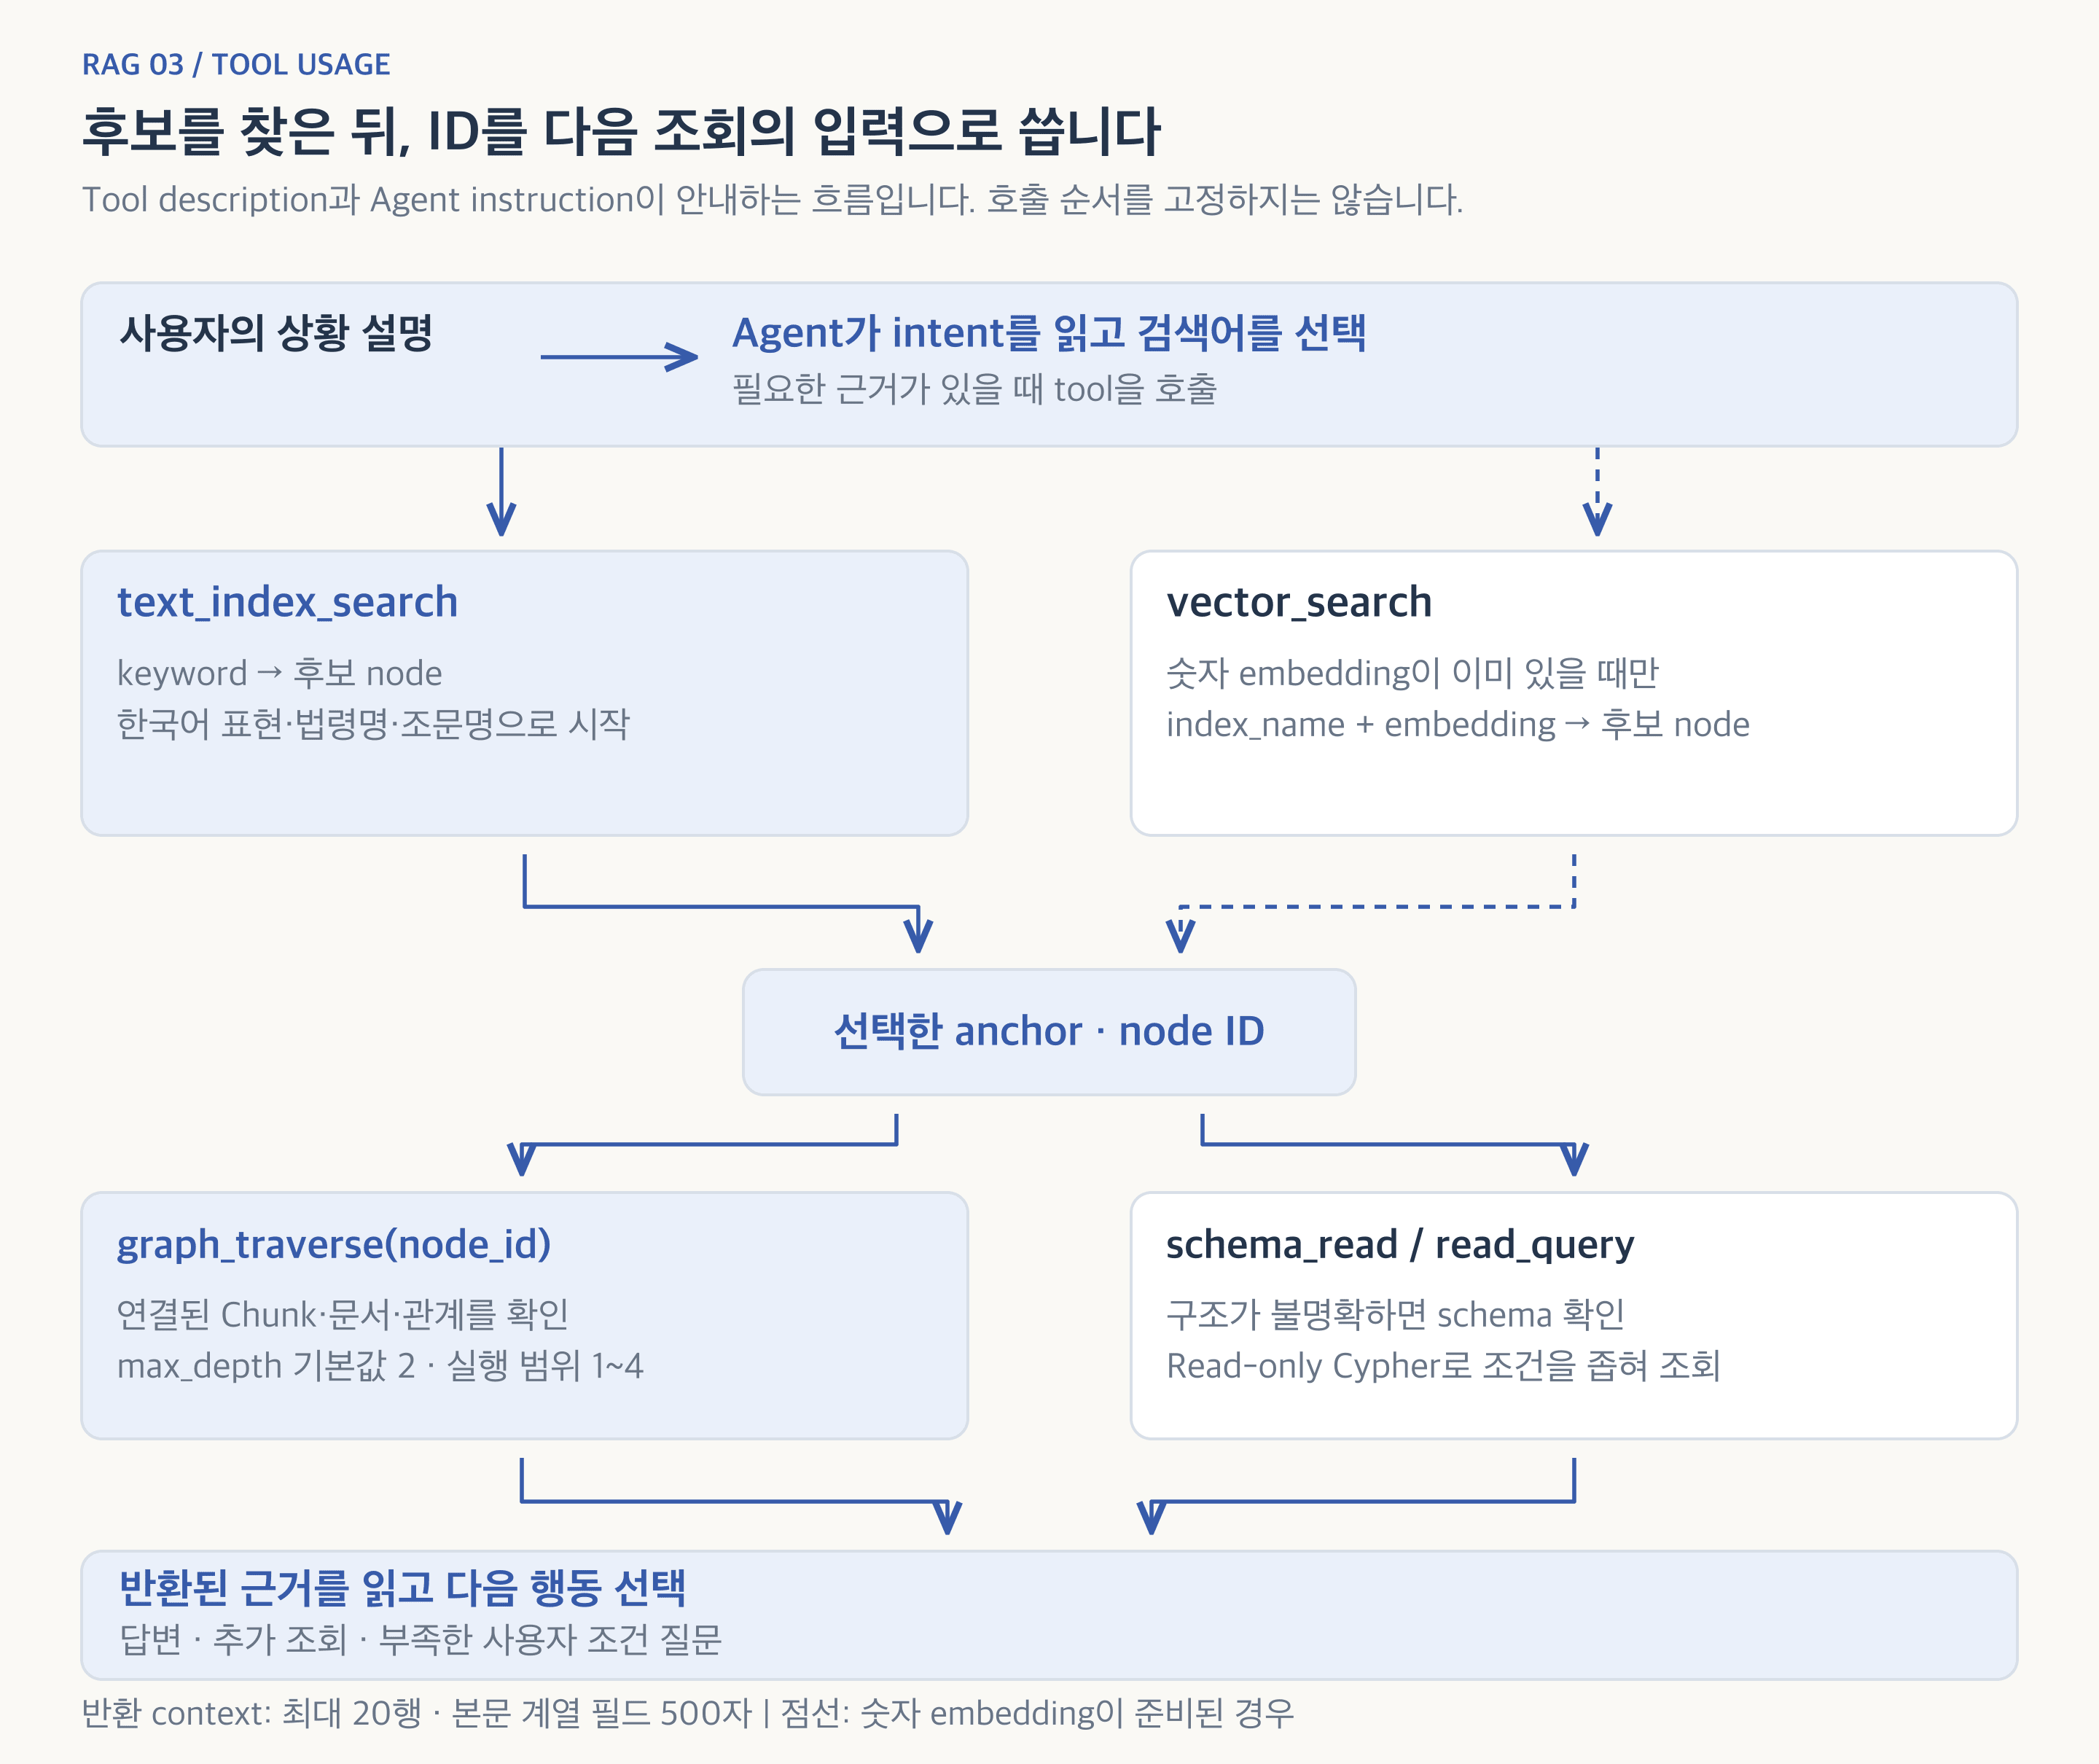
Agent는 처음부터 Chunk ID를 알지 못합니다. 사용자 상황을 해석한 keyword로 text_index_search를 호출해 후보를 찾고, 관련 있는 node의 id를 graph_traverse의 node_id로 넘기도록 했습니다. 숫자 embedding이 준비된 경우에는 vector_search도 시작점이 됩니다. 후보가 Document라면 HAS_CHUNK로 연결된 Chunk를 확인하고, 질문에 필요한 본문·정의·조건이 있는지 읽는 단계가 이어집니다.
DB에 저장한 데이터와 Agent에게 반환하는 데이터는 구분해야 합니다. 현재 text_index_search와 vector_search의 대상은 지정한 index에 따르며, 함수 자체에 Chunk label 제한은 없습니다. Text 검색의 fallback은 모든 node의 property를 조회하며 Document.raw_content도 검색 문자열에 포함합니다. graph_traverse 역시 node·관계 종류를 제한하지 않으므로 Document나 검토 기록이 경로에 포함될 수 있습니다.
반환 단계에서는 raw_content·embedding·metadata 필드를 제거합니다. Fallback의 matched_text는 별도 문자열이므로 앞 200자의 발췌와 잘림 표시가 남을 수 있습니다. 즉 Document의 원문 전체를 context에 넣으려는 설계는 아니지만, Document가 검색 대상에서 제외된 구현도 아닙니다. 상담을 근거 graph로 한정하려면 검색 label·traversal 관계·반환 필드를 명시하는 추가 제한이 필요합니다.
2. 시작 node를 찾고 연결된 근거를 따라갑니다
Embedding은 후보를 찾기 위한 표현입니다
코드의 기본 설정은 Chunk.text를 OpenRouter의 openai/text-embedding-3-large로 embedding하고, 3,072차원 vector와 모델 이름을 같은 Chunk에 저장하는 구성입니다. 질문 vector를 이용하는 검색에서는 저장된 vector와 호환되는 모델·차원을 맞춰야 합니다. 이 모델과 차원이 다른 선택보다 우수한지는 별도 비교가 남아 있습니다.
사용자가 법률명이나 조항을 모르고 상황을 설명할 때는 입력 표현과 법령 용어 사이의 차이를 좁혀야 합니다. Agent가 intent를 해석해 candidate keyword를 만드는 패턴은 RAG 02에서 다뤘습니다. 여기서는 그 keyword 또는 준비된 질문 vector가 어떤 후보 node를 반환하고, 그 ID로 어떤 조회를 이어갈 수 있는지에 초점을 둡니다.
현재 MCP의 text_index_search는 자연어 keyword·법령명·조문명으로 시작 node를 찾도록 안내합니다. vector_search는 이미 생성된 숫자 embedding을 받습니다. 따라서 모든 사용자 질문이 자동으로 embedding 검색부터 시작하는 구조는 아닙니다. Text 검색 호출에서 특정 미존재 오류를 받으면 CONTAINS 조회로 대체합니다. 모든 index 오류를 복구하는 구현은 아니므로 평가할 때는 index 검색과 fallback을 구분해야 합니다.
HNSW의 근접 그래프와 법령의 참조 graph
HNSW는 여러 층의 근접 그래프를 이용해 가까운 vector 후보를 찾는 index 방식입니다. 법령의 참조 graph는 찾은 조항에서 다른 정의·조건으로 이어지는 관계입니다. 두 구조의 역할을 나눠, 후보가 비슷하다는 이유만으로 적용할 근거가 충분하다고 판단하지 않도록 했습니다.
구현에는 Memgraph의 vector 검색 호출이 있습니다. 실제 DB의 index 정의·HNSW 설정에 따른 recall과 지연은 아직 비교하지 않았습니다.
검색 원리 참고: HNSW 원 논문 · Memgraph vector search.
Anchor를 찾은 뒤에는 관계를 확장합니다
text_index_search의 description에는 후보 node를 찾으면 작은 keyword 변형을 반복하기보다 graph_traverse나 read_query로 연결된 근거를 확인하라는 안내를 넣었습니다. Main Agent의 instruction도 anchor 주변의 chunk·문서·관계를 먼저 읽고 부족할 때 추가 검색을 사용하도록 안내합니다.
graph_traverse는 node_id를 받아 인접 경로를 읽습니다. max_depth의 기본값은 2이며 query layer에서 1~4로 조정합니다. 현재 구현은 관계 종류와 방향을 따로 지정하지 않는 주변 경로 조회입니다. 특정 관계나 조건으로 좁히는 조회는 schema를 확인한 뒤 read_query로 표현하도록 역할을 나눴습니다.
첫 검색의 top-K, traversal의 hop 깊이, 반환 path 수, Agent의 context에 남기는 양은 각각 다릅니다. 반환 경로에 LIMIT를 두었다고 DB 내부에서 탐색한 전체 node 수까지 같은 값으로 제한되는 것은 아닙니다. 검색 후보에서 필요한 근거까지 도달했는지와 그 비용을 함께 확인해야 합니다.
3. 이 조회 방식을 지원할 database를 선택했습니다
로디에서는 원문 text와 embedding을 같은 Chunk node에 두고, 검색 결과의 ID로 문서와 연결된 관계를 이어 조회하도록 Memgraph를 사용했습니다. Vector 검색 결과를 별도 graph 저장소의 대상으로 다시 맞추는 작업을 줄이고, 승인된 관계의 근거도 같은 graph에서 읽으려는 선택이었습니다.
관계를 테이블로 표현하거나 vector 저장소와 관계 저장소를 나누는 구성도 가능합니다. 그런 구성에서는 여러 단계의 참조를 읽을 query와 두 저장소의 ID·갱신·삭제를 맞추는 방식을 함께 설계해야 합니다. Memgraph에서는 이 요구를 Cypher와 node·edge 모델 안에서 다뤘습니다. 대신 graph와 vector index의 메모리, 관계 schema와 조회 범위를 함께 관리해야 합니다.
이 선택은 같은 근거 ID로 검색과 참조 조회를 이어가기 위한 것이었습니다. DB 간 성능·운영 비용 비교는 별도 과제로 남아 있습니다.
4. 검색 기능을 Agent가 선택할 수 있는 MCP tools로 만들었습니다
이름과 description, 입력값을 함께 설계했습니다
저장 구조에서 Chunk ID는 다음 조회의 입력이 되고, 관계는 주변 근거로 이동할 경로가 됩니다. Memgraph의 text/vector index 조회를 후보 검색 tool로, 경로 query를 graph_traverse로, 조건을 지정하는 Cypher를 read_query로 노출했습니다. schema_read는 Agent가 label·관계·property·index를 확인할 때 사용합니다. 이처럼 DB schema가 저장 대상을 정한다면 MCP input schema는 Agent가 그 기능을 호출하는 형식을 정합니다. FastMCP에는 목적별 이름·description·typed parameter·기본값을 함께 등록했습니다.
| Tool | 입력 형식과 기본값 | 사용 시점과 다음 행동 |
|---|---|---|
memgraph.text_index_search | keyword: string | 자연어 keyword로 후보 node를 찾습니다. Anchor를 얻으면 graph를 확장합니다. |
memgraph.vector_search | index_name: string | 숫자 embedding이 준비됐을 때 후보를 찾습니다. 반환된 node ID로 관계를 조회합니다. |
memgraph.graph_traverse | node_id: string | 확인한 anchor 주변의 경로를 읽습니다. 필요한 조건 조회는 read_query로 이어갑니다. |
memgraph.schema_read | 입력 인자 없음 | Label·관계·property·index를 확인하고 조회에 사용할 구조를 파악합니다. |
memgraph.read_query | query: string | Read-only Cypher로 조건을 좁혀 근거와 출처를 조회합니다. |
의도한 순서는 ① keyword로 후보 검색 ② 반환된 node와 발췌를 읽고 anchor 선택 ③ 그 ID로 graph_traverse 호출 ④ 더 좁은 조건이 필요하면 read_query 실행입니다. Label이나 관계 이름이 불명확하면 해당 조회 전에 schema_read를 사용합니다. 근거가 부족할 때만 추가 검색으로 돌아가도록 instruction에 적었으며, 이 순서를 서버의 고정 workflow로 강제하지는 않았습니다.
상황 설명에서 다음 조회로 이어지는 입력
다음은 도구 계약을 설명하기 위한 재구성입니다. 앞의 퇴직 상담 질문에서 Agent가 ‘퇴직급여’를 검색어로 골랐다고 가정합니다. 실제 검색 성공이나 법률 판단을 나타내는 예시는 아닙니다.
- 후보 검색
text_index_search에keyword: "퇴직급여"를 넘깁니다. 결과의 node 본문·발췌에서 관련성을 읽고, 선택한 node의properties.id를 보관합니다. - 같은 ID로 참조 확인
선택한 ID를
graph_traverse의node_id에 넘깁니다. 반환 경로에서 연결된 정의와 조건을 읽습니다. 이미 anchor가 있으므로 작은 검색어 변형을 반복하기보다 주변 근거를 먼저 확인하도록 안내했습니다. - 부족한 조건에 맞춰 선택
특정 문서나 관계만 필요하면
read_query로 좁힙니다. Label과 관계를 모르면schema_read로 먼저 확인합니다. 근거가 갖춰졌더라도 근무 조건을 모르면 사용자에게 질문할 수 있습니다.
핵심은 특정 검색어를 반드시 쓰게 하는 것이 아니라, 반환된 ID와 내용이 다음 입력을 결정하게 하는 데 있습니다. 실제 응답의 node·path 구조와 호출 순서는 별도로 기록해 검증해야 합니다.
다음은 MCP 등록 코드에서 tool 이름·description 일부와 함수 입력을 발췌한 내용입니다. 실제 tools/list 응답을 캡처한 자료와는 구분합니다. Description의 생략 구간과 실행 본문은 제외했습니다. ‘첫 검색에 사용’과 ‘anchor를 얻은 뒤 확장’이라는 사용 지침이 함수의 입력 형식과 함께 Agent에게 전달됩니다.
MCP 등록 코드 발췌 · rag/be/src/api/mcp/server.py
@mcp.tool(
    name="memgraph.text_index_search",
    description=(
        "Use this first for plain Korean keywords, "
        "law names, article names, "
        # … description 중간 생략
        "Do not repeatedly call this with small keyword variants "
        "when an anchor node id is already available; "
        "expand the graph from the anchor instead. "
        # … description 나머지 생략
    ),
)
def memgraph_text_index_search(
    keyword: str,
    top_k: int = 20,
    index_name: str | None = None,
) -> dict[str, Any]:
    # 실행 본문 생략
이름·description·typed parameter가 MCP tool의 호출 계약을 구성합니다. graph_traverse의 max_depth는 정수와 기본값 2로 정의하고 실제 범위 1~4는 query layer에서 조정합니다. 현재 tool description에는 documents·review notes까지 조회하라는 안내도 있어, 근거 데이터만 사용하도록 좁히려면 instruction과 서버의 조회 범위를 함께 맞춰야 합니다. 반환 타입은 일반 dict이며 도메인 필드 전체를 엄격한 output schema로 검증하지는 않습니다.
참고: MCP tool 정의 — description·inputSchema·outputSchema
반환 결과가 다음 판단에 필요한 context가 되도록
Agent에 전달할 결과는 최대 20행으로 줄이고, text·summary·evidence_text 등 본문 계열 필드는 앞 500자, 그 밖의 문자열 property는 앞 200자를 남기고 초과하면 잘림 표시를 붙입니다. raw_content·embedding·metadata는 필드 이름을 기준으로 제외합니다. Node ID·관계·짧은 근거를 다음 판단에 쓰도록 만든 projection이며, 검색 대상의 label을 제한하는 기능과는 별도입니다.
returned_row_count와 truncated_rows는 반환량을, elapsed_ms는 조회 시간을 확인하는 값입니다. 이 결과는 후보를 살피는 데 필요한 요약이므로 잘린 부분에 조건이나 예외가 있는지도 확인해야 합니다. 필요한 원문은 read_query에서 문서와 범위를 좁혀 짧은 발췌로 다시 조회하는 흐름을 사용 지침과 함께 검증해야 합니다.
Read-only MCP와 상담 Agent 연결
RAG 조회 MCP는 FastMCP의 stateless HTTP와 JSON 응답으로 구성했습니다. 상담 backend는 MCP client로 tool 목록을 가져와 Agent에 등록합니다. Client에서 사용할 수 없는 문자는 tool 이름에서 정리하고, 원래 MCP 이름은 description에 남겨 서버의 정의와 연결했습니다.
상담에 공개한 것은 검색·schema·읽기 query입니다. read_query는 문자열·주석을 제외한 query에서 쓰기 명령과 일부 procedure 이름을 검사합니다. 모든 procedure의 동작이나 DB 계정 권한까지 보장하는 검사는 아닙니다. Chunk와 관계 후보를 쓰는 내부 도구는 Construction 쪽에 두었습니다. 그 내부 도구와 worker 구성은 RAG 04에서 다룹니다.
상담 backend에는 RAG 조회 MCP와 외부 API MCP를 별도로 연결합니다. 전자는 저장된 법령·조례를 읽고, 후자는 Naver·Firecrawl·TMAP로 웹 정보와 기관·위치를 찾는 기능입니다. 질문의 현재성과 필요한 문서 근거에 따라 두 정보원을 선택하도록 안내했습니다. 외부 API의 연결 검사 결과를 RAG 검색 품질로 계산하지 않습니다.
Tool 실행이나 입력 검증에 실패하면 오류를 근거로 사용하지 말고 다른 검색이나 더 단순한 입력을 선택하도록 안내합니다. 같은 오류를 반복하지 않고 이미 확보한 근거와 부족한 조건을 바탕으로 다음 행동을 정하게 하려는 처리입니다.
5. 조회 계약과 답변에 필요한 근거를 따로 검증합니다
구현한 범위는 후보 검색·관계 탐색·조건 조회를 연결하는 도구와 그 사용 지침입니다. 지침대로 anchor를 이어 썼는지, 필요한 정의와 예외까지 확보했는지는 실제 호출·반환과 최종 인용을 함께 봐야 합니다.
현재 확인한 범위
| 확인할 대상 | 확인한 내용 | 남은 검증 |
|---|---|---|
| 호출 계약 | 5개 tool 등록, 입력 기본값과 description, 결과 축소 구현 | 실제 tools/list 응답과 호출·반환 대조 |
| 조회 제한 | 읽기 query 검사와 projection을 다루는 mock 기반 테스트 코드 | 해당 버전의 테스트 실행 기록과 실제 DB 검사 |
| 검색·답변 품질 | 후보 ID로 주변 경로를 조회하는 구현 | 필수 근거 확보율과 인용·적용 조건 평가 |
테스트 코드가 있다는 사실과 실행을 통과한 기록은 구분했습니다. 이번 글의 검증 범위는 코드 대조이며, 동일 조건의 검색·답변 품질과 응답 시간 비교는 후속 실험으로 남아 있습니다.
다음 실험은 시작 node 선택과 관계 탐색을 나눠 봅니다
사용자가 일상적인 말로 상황을 설명한 질문과 정확한 법률·조·항을 지정한 질문을 같은 정보 요구로 짝지어 구성할 계획입니다. 각 질문에는 필요한 조항과 조건, 도달 가능한 시작 node, 허용되는 추가 질문을 사람이 검수해 붙입니다.
첫 비교는 입력 그대로 검색, 고정 query rewriting, Agent의 candidate keyword 검색입니다. 같은 corpus·chunk·graph·index·모델과 호출·context 예산을 사용하고, 먼저 같은 확장 정책 안에서 검색어 생성의 영향을 비교합니다. 이후 Agent가 추가 조회·질문·종료를 고르는 판단의 영향을 분리합니다.
Text index 검색과 vector 검색은 별도로 평가합니다. Vector 경로는 동일한 embedding 모델로 질문 vector를 만들고, text index 미구성에 따른 CONTAINS fallback이 실행됐는지도 query 계층에서 확인해야 합니다. 현재 MCP 결과 정리 과정에서 일부 검색 모드 정보가 제외되므로, 평가용 로그에 필요한 값이 남는지도 먼저 점검합니다.
측정할 값
시작 node: 정답 근거에 도달 가능한 후보의 Recall@K·MRR를 봅니다. 정확한 식별자를 준 질문과 일상어 질문의 차이를 구분합니다.
관계 탐색: 같은 hop 깊이와 확장 조건에서 필요한 본문·정의·예외 조항을 얼마나 확보했는지 봅니다. 시작 node를 놓친 경우와 관계 탐색 중 놓친 경우를 나눕니다.
답변과 비용: 인용이 실제 근거를 뒷받침하는지, 지역·시점·조건이 맞는지 확인하고 무관한 context 비중·호출 수·token·latency를 같은 실행에 연결합니다. 중첩·병렬 구간은 중복 합산하지 않습니다.
검색 필요성: 매 응답 전 retrieval과 필요한 시점의 retrieval을 별도로 비교합니다. 인사·사용법·사용자 조건 보완 turn에서 불필요한 검색이 생기는지도 포함합니다.
Trace에 남길 연결
사용자 입력 → 후보 keyword → 호출 tool과 parameter → 반환 node와 근거 → 선택한 anchor → traversal 경로 → 추가 조회 또는 질문 → 최종 인용을 연결합니다. 숨은 추론 대신 관측 가능한 호출과 결과를 기록합니다.
빈 결과·tool 오류·관련 없는 결과를 구분하고, 추가 호출이 새로운 유효 근거를 늘렸는지 확인합니다. 실제 웹을 사용하는 시험과 저장된 검색 응답을 사용하는 시험도 구분해 비교 조건을 맞춥니다.
위 비교는 아직 실행하지 않은 계획입니다. 빈 결과가 반복될 때 추가 호출이 유효한 근거를 늘리는지와 언제 탐색을 끝내는지도 함께 확인하겠습니다.
구현 근거와 검증 자료
구현 기준: RAG backend의 MCP 등록·조회·결과 정리 코드. 계약 테스트는 mock을 이용한 검사이며 실제 DB 성능 평가와 구분합니다.
같은 근거에서 다음 조회로
로디에서는 Document와 Chunk, 참조 관계를 같은 식별자로 조회할 수 있게 구성하고, 후보 검색·관계 확장·schema 확인·조건 조회를 MCP tools로 제공했습니다. 각 tool의 입력과 반환값, description과 instruction을 맞춰 Agent가 필요한 근거를 찾고 다음 조회를 선택하도록 했습니다. 남은 검증은 이 경로가 일상적인 사용자 표현에서도 필요한 조항까지 도달하는지 확인하는 일입니다.