DearMate의 캐릭터는 사용자와 오래 대화하면서 이전의 취향과 약속을 이어서 이야기해야 합니다. 기억·맥락 설계에서는 오래된 대화를 요약하고 필요한 원본 발화를 검색하는 구조를 설명했습니다. 여기서는 요약에 검색을 더했을 때 실제로 답변이 더 정확해졌는지 살펴봅니다.
같은 140문항에서 압축 맥락의 크기와 검색량을 바꾼 21개 조건을 비교했습니다. Level 1에서 검색을 끈 기준선은 77개 정답이었고, 과거 발화 10개를 검색한 조건은 90개 정답이었습니다. 검색을 더 많이 넣은 조건까지 함께 보면, 검색량의 증가가 답변 정확도의 증가로 이어지지는 않았습니다.
현재의 사실과 과거의 사실을 따로 물었습니다
기억을 평가할 때는 “무엇을 기억해야 하는가”부터 구분해야 합니다. 사용자가 예전에는 민트초코를 싫어했지만 지금은 좋아한다고 말한 경우, 현재 취향을 묻는 질문과 예전 취향을 묻는 질문의 정답이 다릅니다. 대화에 없는 사실을 물었을 때는 근거가 없다는 답도 필요합니다.
| 유형 | 문항 수 | 설명용 질문 |
|---|---|---|
| 현재 사실 | 56 | 지금 좋아하는 맛은 무엇인가요? |
| 과거 사실 | 28 | 예전에는 어떤 맛을 싫어했나요? |
| 여러 발화 종합 | 35 | 취향이 어떻게 바뀌었나요? |
| 근거 없음 | 21 | 대화에 등장하지 않은 여행지는 어디인가요? |
답할 수 있는 문항에는 정답과 정답을 뒷받침하는 원본 발화가 연결되어 있습니다. 근거 없는 질문은 연결된 발화가 없습니다. 정답은 응답 채점에 쓰고, 근거 발화는 검색 결과에 필요한 내용이 들어왔는지 확인하는 데 씁니다. 근거를 찾았는지와 그 근거로 맞게 답했는지를 따로 보는 구성입니다.
같은 요약을 고정하고 검색량만 바꿨습니다
평가 중에 요약이 매번 달라지면 검색의 차이를 비교하기 어렵습니다. 그래서 대화별 요약을 미리 만들고 고정한 frozen compaction을 사용했습니다. Level 1은 최초 요약이고, Level 3·5는 그 요약을 더 짧게 줄인 조건입니다.
| 조건 | 요약 토큰 합계 | Level 1 대비 |
|---|---|---|
| Level 1 | 24,615 | 100.00% |
| Level 3 | 8,833 | 35.88% |
| Level 5 | 5,404 | 21.95% |
각 level에서 검색 발화 수 K를 0·10·20·50·100·200·300으로 바꿨습니다. K=0은 요약과 질문만 주는 기준선입니다. K가 0보다 크면 질문으로 같은 대화의 과거 발화를 검색해 더합니다. 질문과 정답, 선택한 level의 요약을 유지한 채 140문항 × 3개 level × 7개 K = 2,940개 응답을 비교했습니다.
답변 모델은 google/gemini-3.1-flash-lite였으며, 각 문항은 이전 평가 문항의 대화 이력이 없는 stateless 경로에서 한 번씩 실행했습니다. 실행 중 자동 compaction도 껐습니다. 검색은 text-embedding-3-large의 1,024차원 표현과 HNSW를 사용했고, 발화의 시각은 검색이 끝난 뒤 모델이 읽는 참고 자료에 붙였습니다.
정확도는 같은 Gemini 모델과 동일한 answer-correctness Judge prompt로 2,940개 응답을 다시 판정한 결과입니다. Judge에는 질문·정답·후보 답변만 주고, K와 검색 성공 여부는 주지 않았습니다. 아래 결과는 이 재평가 묶음 안에서 비교하며, 먼저 작성된 다른 Judge의 점수와 섞지 않았습니다. 응답 생성은 2026년 8월 19~20일 UTC, 재평가는 8월 20일 UTC에 기록되어 있습니다.
소량의 검색이 요약만 읽은 조건을 보완했습니다
Level 1에서 K=0은 77/140, 55.00%였고 K=10은 90/140, 64.29%였습니다. 정답 13개, 정확도 9.29%p 차이입니다. 더 짧은 Level 5에서는 K=0의 72/140에서 K=20의 90/140으로 정답 18개, 12.86%p 차이가 났습니다.
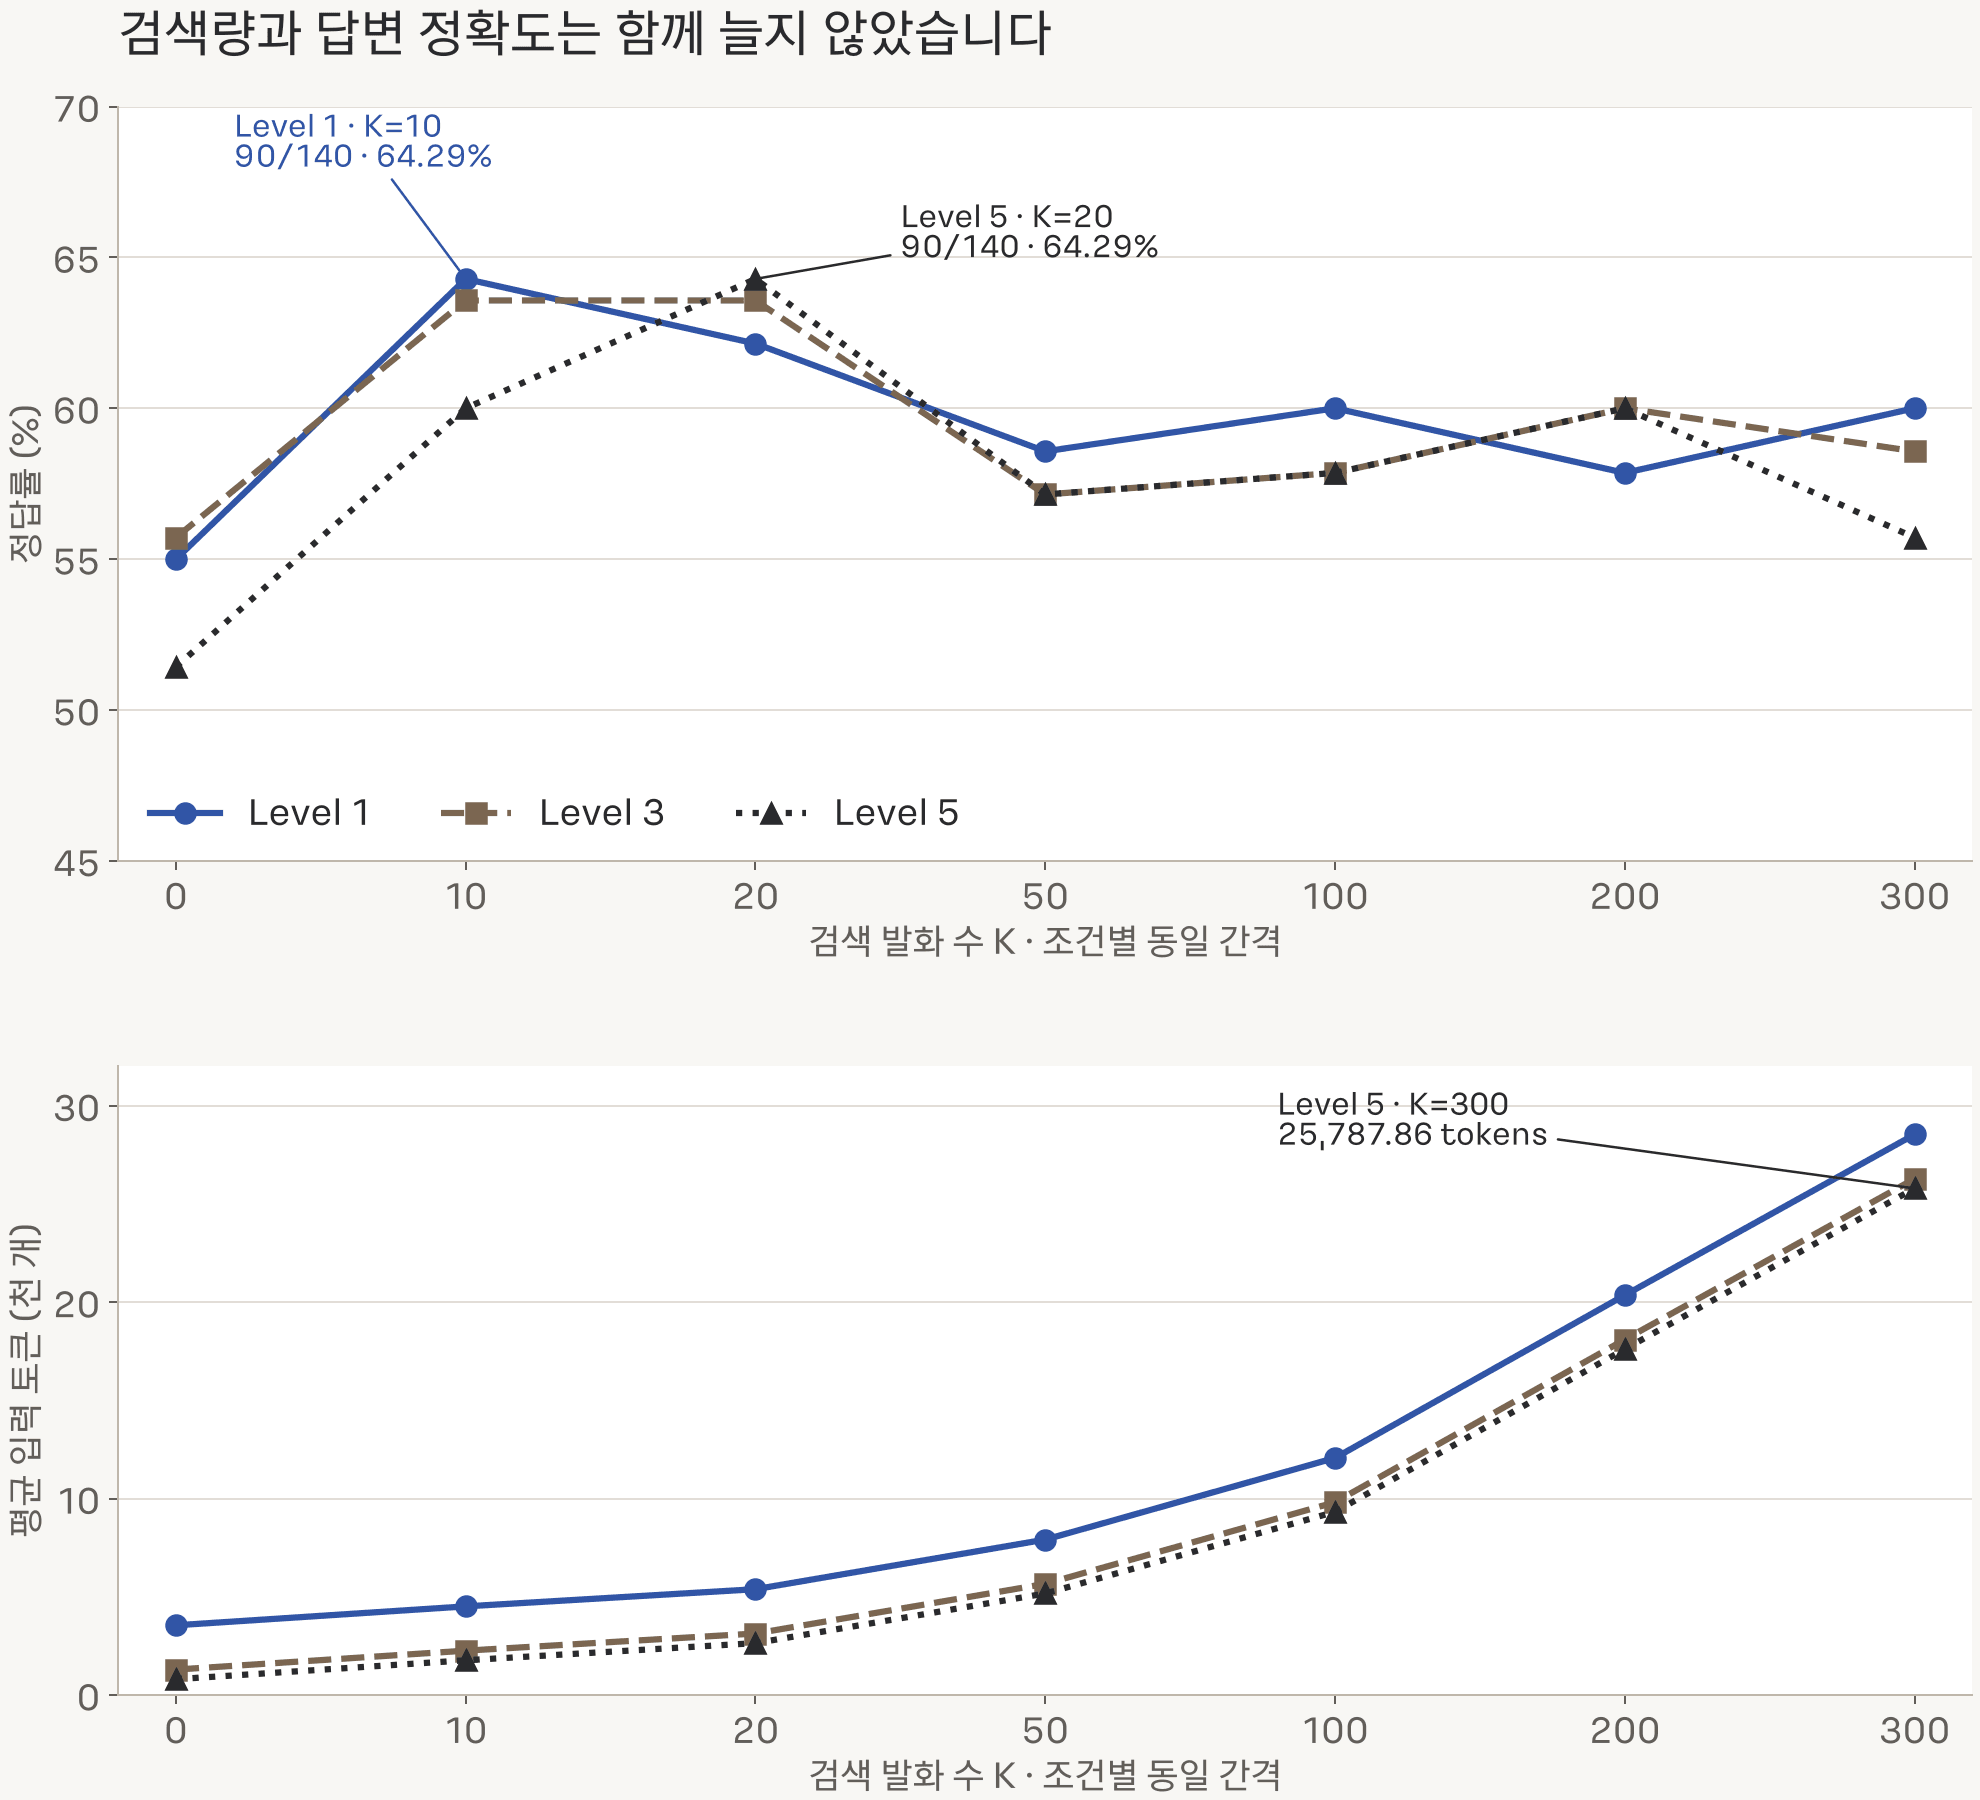
| 검색량 K | Level 1 | Level 3 | Level 5 |
|---|---|---|---|
| 0 | 77/140 · 55.00% | 78/140 · 55.71% | 72/140 · 51.43% |
| 10 | 90/140 · 64.29% | 89/140 · 63.57% | 84/140 · 60.00% |
| 20 | 87/140 · 62.14% | 89/140 · 63.57% | 90/140 · 64.29% |
| 50 | 82/140 · 58.57% | 80/140 · 57.14% | 80/140 · 57.14% |
| 100 | 84/140 · 60.00% | 81/140 · 57.86% | 81/140 · 57.86% |
| 200 | 81/140 · 57.86% | 84/140 · 60.00% | 84/140 · 60.00% |
| 300 | 84/140 · 60.00% | 82/140 · 58.57% | 78/140 · 55.71% |
Level 1의 최고점은 K=10, Level 3은 K=10·20, Level 5는 K=20이었습니다. 이 비교에서는 10~20개 검색이 유용한 후보였지만, 세 level마다 가장 높은 점수를 사후에 고른 사실도 함께 봐야 합니다. 실제 서비스의 K를 결정하려면 같은 K를 유지한 비교와 새 대화에서의 검증이 이어져야 합니다.
검색량을 늘리면 읽을 내용은 늘지만 정답은 흔들렸습니다
Level 5의 K=20에서 평균 입력은 2,640.54 tokens였고 정확도는 64.29%였습니다. K=300에서는 평균 25,787.86 tokens로 약 9.77배 늘었지만 정확도는 55.71%였습니다. 입력이 길어진 조건에서 정답이 12개 줄었습니다.
| 조건 | 정답률 | 평균 입력 토큰 |
|---|---|---|
| K=0 | 72/140 · 51.43% | 804.05 |
| K=20 | 90/140 · 64.29% | 2,640.54 |
| K=300 | 78/140 · 55.71% | 25,787.86 |
K=0에는 최종 prompt 원문 열이 없어 고정 요약과 질문을 실행 템플릿에 맞춰 재구성한 뒤 토큰을 셌습니다. 검색 조건은 저장된 최종 agent_prompt를 그대로 셌습니다. 따라서 이 토큰 수는 비교한 입력 본문의 크기이며, 모델의 전체 청구 토큰이나 응답 지연을 측정한 값은 아닙니다.
저장된 검색 결과와 같은 Judge의 오답을 함께 대조하면 차이가 더 드러납니다. Level 5·K=300에서는 정답 근거로 지정한 발화가 하나 이상 검색된 97문항 중 50문항이 오답이었습니다. 이 집계는 필요한 근거가 모두 들어왔다는 뜻은 아닙니다. 최소 하나의 근거를 찾은 뒤에도, 남은 근거의 누락과 답변의 선택 오류를 더 구분해 봐야 하는 사례입니다.
민트초코 사례에서도 과거의 “싫어요”와 최근의 “좋아요”가 모두 검색될 수 있습니다. 두 근거가 들어왔다고 현재 취향 질문에 맞게 답한 것은 아닙니다. 시점을 구분해 최신 발화를 골랐는지까지 확인해야 합니다. 이 예시는 실패 위치를 설명하기 위한 재구성이며, 위 정확도의 특정 오답 원인을 새로 판정한 결과는 아닙니다.
이번 결과가 보여주는 범위는 이 데이터와 모델에서의 관측입니다. 조건마다 한 번씩 생성한 답변이고, 답변 모델과 Judge가 같습니다. 반복 실행의 변동과 사람의 별도 채점은 후속 확인이 필요합니다. K가 커질 때의 정확도 하락을 특정 원인 하나로 설명하기보다, 검색된 근거와 최종 선택을 나눠 점검할 근거로 사용했습니다.
기억량과 입력 예산을 함께 결정해야 합니다
검색량은 요약의 손실을 보완하는 정도와 모델이 읽을 입력의 크기를 함께 바꿉니다. 같은 질문에서 적은 수의 검색이 도움이 된 결과를 바탕으로, K=10·20을 유지한 비교와 최신·과거 사실별 실패를 다음 평가 후보로 삼을 수 있습니다. 이 행렬 자체가 운영 설정의 최적값을 확정한 결과는 아닙니다.
입력 길이 자체의 부담은 별도의 장문 지시 이행 실험에서도 다뤘습니다. 같은 family를 맞춘 16K→32K 비교에서 수행이 떨어진 관찰은 입력을 계속 늘리는 데 신중해야 할 근거였습니다. 해당 실험의 과제와 점수는 기억 QA와 다르므로, 여기서는 입력 예산 판단을 잇는 자료로 연결합니다.
현재 구현은 저장 맥락의 예산과 최근 대화 보존을 코드 정책으로 두고 있습니다. 실험 조건을 실제 대화 흐름에 옮길 때는 압축 전후의 기억, 검색 반영 시점, 응답과 저장의 완료 여부를 함께 확인해야 합니다. 그 실행 경계는 다음 글의 응답 준비·저장·비동기 후처리로 이어집니다.