DearMate는 SNS에서 만난 AI 인플루언서와 개인 대화를 이어 가는 서비스입니다. 공개 콘텐츠와 대화에서 같은 인물을 만나려면 성격 설정이 실제 답변에도 드러나야 합니다. 앞선 구성 요소 글에서 정리한 요구 중, 이 글은 페르소나의 대화 규칙과 긴 입력에서 그 규칙을 따르는 조건을 다룹니다.
먼저 반복되는 위로와 질문 습관을 줄이도록 응답 규칙을 구체화했습니다. 이어서 처음 받은 지시를 긴 맥락 뒤에도 따르는지 실험했습니다. 대화의 매력은 사람의 판단이 필요한 반면, 최초 지시 이행은 출력 형식과 정답을 정해 비교할 수 있었습니다.
1. 성격을 응답의 규칙으로 옮겼습니다
초기 모델 비교에 사용할 페르소나는 팀원 윤경님이 담당했습니다. 팀은 캐릭터의 성격과 말투를 system prompt로 정리하고, 내부 LLM Arena에서 같은 대화에 대한 여러 모델의 답변을 비교했습니다. 이 설정과 대화 경험이 이후 규칙을 다듬는 출발점이었습니다.
설정이 자세해도 비슷한 위로를 반복하거나 매번 질문을 되돌려 주면 인물의 성격보다 응답 패턴이 먼저 드러났습니다. “공감하면서 자기 생각도 말하는 인물”이라는 설명에 더해, 여러 턴에 걸쳐 어떤 반응을 피하고 어떤 소재를 꺼낼지 정해야 했습니다.
See et al.의 대화 품질 연구는 반복·구체성·주제 관련성·질문 빈도를 조절하고 사람이 여러 턴 대화한 뒤 품질을 평가했습니다. 이 관점을 참고해 반복 억제, 질문 없는 응답, 답변 길이에 맞는 구체성을 프롬프트의 행동 규칙으로 옮겼습니다. 논문의 학습·디코딩 기법을 재현한 작업은 아닙니다.
| 대화에서 다룰 문제 | 규칙에 반영한 내용 | 선택 이유 |
|---|---|---|
| 반복되는 위로 | 최근 표현뿐 아니라 문장 구조와 리액션 패턴도 반복하지 않도록 했습니다. | 같은 공감 문장이 이어지면 상대의 말을 구체적으로 듣는 느낌이 약해집니다. |
| 매번 되돌아오는 질문 | 질문 없이 자기 이야기나 반응만 하는 턴도 충분히 두었습니다. | 사용자가 계속 답해야 하는 대화 패턴을 줄이려 했습니다. |
| 막연한 일상 이야기 | 두 문장을 넘길 때 구체적인 소재 하나를 넣되 사용자 발화 길이에 맞추도록 했습니다. | 짧은 연락 말투를 유지하면서도 인물의 일상이 드러나게 했습니다. |
같은 발화에 어떤 차이를 기대했을까
다음은 초기·수정 규칙의 차이를 보여 주는 설명용 재구성입니다. 실제 모델을 다시 실행한 응답이나 개선율을 측정한 자료가 아닙니다.
| 사용자 발화·상황 | 초기 규칙 기준 재구성 | 수정 규칙 기준 재구성 |
|---|---|---|
| 안녕 | 안녕 오늘 뭐해써? 나 안 보고 싶었어? | 웅 안녕. 나 방금 운동 끝났어. |
| 앞서 ‘많이 힘들었겠다’는 답변을 들은 뒤: 오늘도 과제가 쌓였어 | 오늘도 많이 힘들었겠다. 무슨 과제야? | 오늘도 과제에 치였네. 잠깐 쉬고 하자, 내가 옆에 있을게. |
| 주말에는 뭐 하고 지냈어? 어떤 일이 있었는지 궁금해 | 운동하고 친구들도 만났어. 재밌게 보냈지. 주말 어땠어? | 토요일 오후에 성민이랑 축구했어. 끝나고 국밥 한 그릇 먹었는데 그게 더 생각나더라. 지금도 허벅지 뻐근해. |
초기 프롬프트로도 오른쪽과 같은 답변이 나올 수 있습니다. 설계에서 바뀐 부분은 원하는 응답과 피할 패턴을 명시한 점입니다. 내부 Arena에서는 더 대화하고 싶어진다는 정성적 반응이 있었지만, 모델과 프롬프트가 함께 바뀌어 규칙 수정의 효과만 분리해 측정하지는 못했습니다.
그다음에는 이렇게 정한 규칙이 긴 대화 뒤에도 작동하는지 확인해야 했습니다. “지훈답다”는 판단에는 말투와 관계 맥락, 평가자의 취향이 함께 들어갑니다. 그래서 장문 실험에서는 평가 대상을 최초 지시 이행으로 좁혔습니다.
2. 첫 지시는 한 번만 주고, 방해 문맥을 늘렸습니다
연구 질문은 같은 질문과 정답을 유지해도 입력이 길어지면 처음 받은 규칙과 정답 회수가 흔들리는가였습니다. 모델이 지원하는 최대 context window와 실제 대화에서 사용할 입력 예산을 구분하려 했습니다.
검토한 LIFBench OneDoc 자료는 같은 식별자라도 길이별 질문·선택지·정답이 달랐습니다. 이에 질문과 정답 문서가 corpus에서 분리되어 있는 Google DeepMind LOFT의 retrieval 자료를 재구성했습니다. 공식 prompt가 마지막 질문에도 반복하던 출력 지시를 빼고, 첫 system 메시지에만 규칙을 넣었습니다.
- 질문과 정답을 고정했습니다. NQ·HotpotQA·MuSiQue·QAMPARI·QUEST의 550개 질문 family에서 데이터셋·split·정답 문서 수에 따라 55개를 층화 추출했습니다. family는 질문과 정답 집합이 같은 단위입니다.
- 처음에만 출력 형식을 지정했습니다. 필요한 문서 ID를 빠짐없이 JSON 객체 하나로 반환하고, 설명이나 무관한 ID를 붙이지 않도록 했습니다.
- 방해 문맥(distractor)을 늘렸습니다. 정답 문서는 별도 정답 표시 없이 history 전반에 균등 배치했습니다. 나머지는 원본 LOFT 문서로 채우고 길이가 부족할 때 Webis-Touche corpus로 보충했습니다.
- 마지막에는 질문만 제시했습니다. 같은 질문·정답·최초 지시를 길이 조건 전체에서 재사용했습니다. API의 structured output 기능으로 JSON을 강제하지 않았습니다.
| 항목 | 조건 |
|---|---|
| 공통 입력 목표 | 2K · 4K · 8K · 16K · 32K · 64K · 110K tokens |
| 길이 기준 | o200k_base로 센 메시지 내용입니다. provider가 보고한 실제 입력 토큰과 구분하고 응답용 4,096 tokens를 남겼습니다. |
| 변경 변수 | 질문·정답 집합·첫 지시는 유지하고 distractor의 양을 바꿨습니다. |
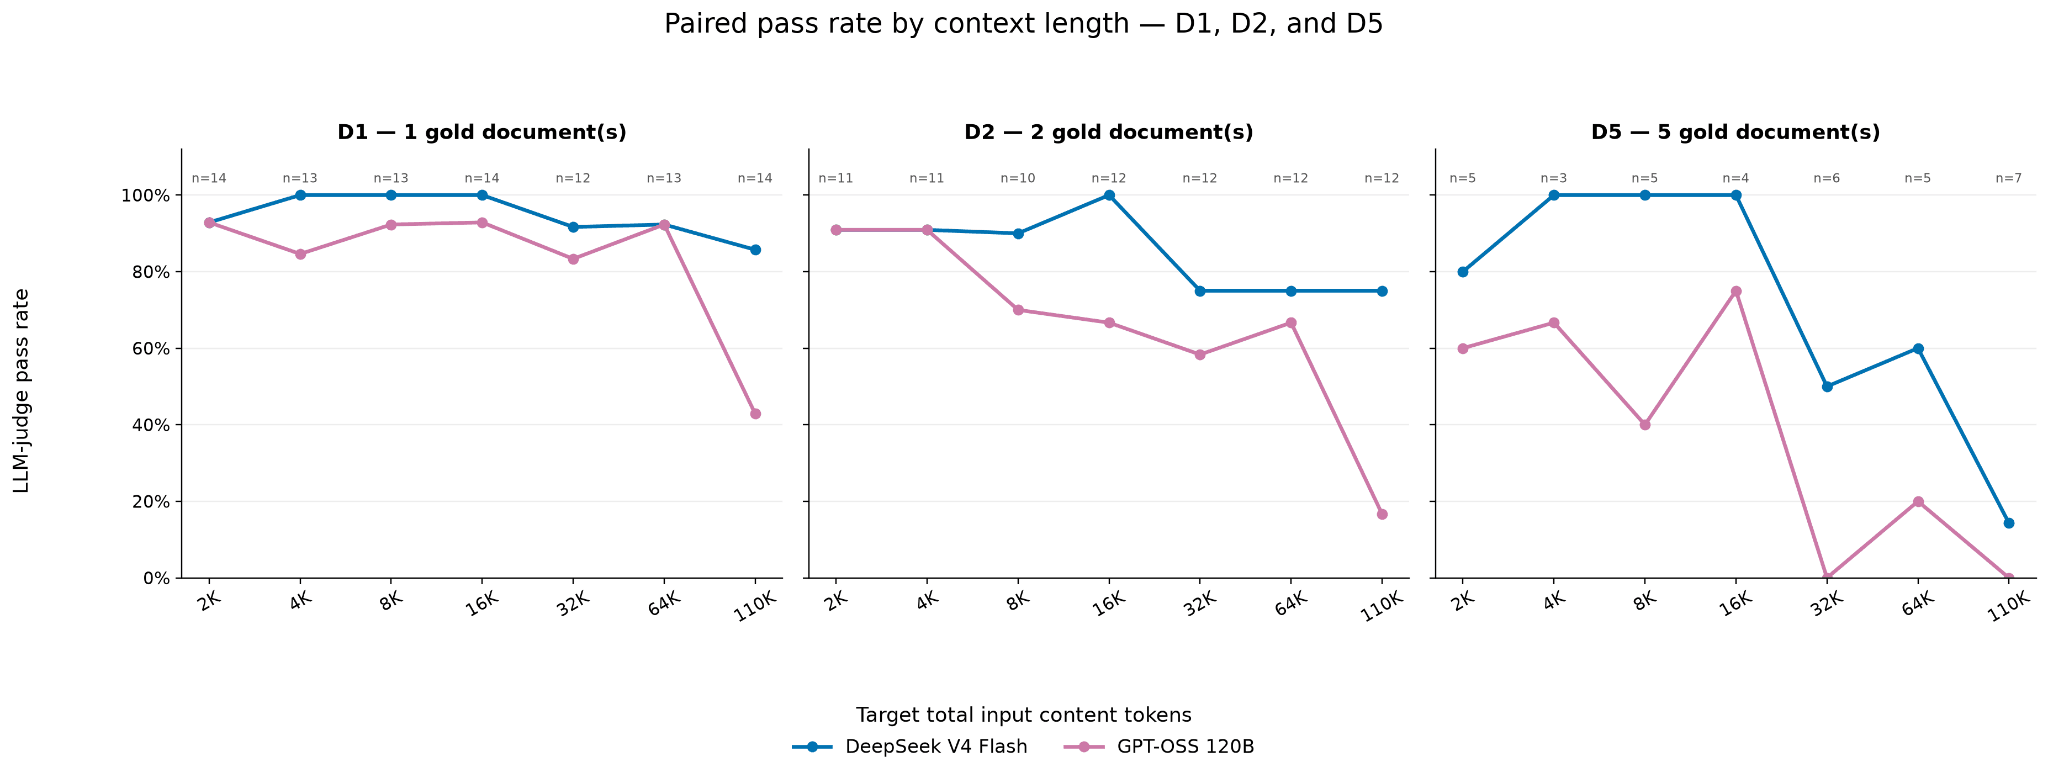
| D1–D5 | 찾아야 할 정답 문서 수 1–5개입니다. 의미적 난이도를 검증한 등급은 아닙니다. |
| 결과 시점 | 2026년 8월에 수집·판정한 보관 결과입니다. 원본 LOFT의 공식 점수가 아닌 DearMate의 재구성 실험입니다. |
완료한 조건이 달라 비교 범위를 맞췄습니다
반복 실험의 비용을 고려해 GPT-OSS 120B를 기준선으로 두고 DeepSeek V4 Flash 등과 비교했습니다. GLM-5 Turbo는 응답 지연과 실행 시간, Gemini 3.1 Flash Lite는 API 비용 때문에 계획한 조건을 모두 마치지 못했습니다.
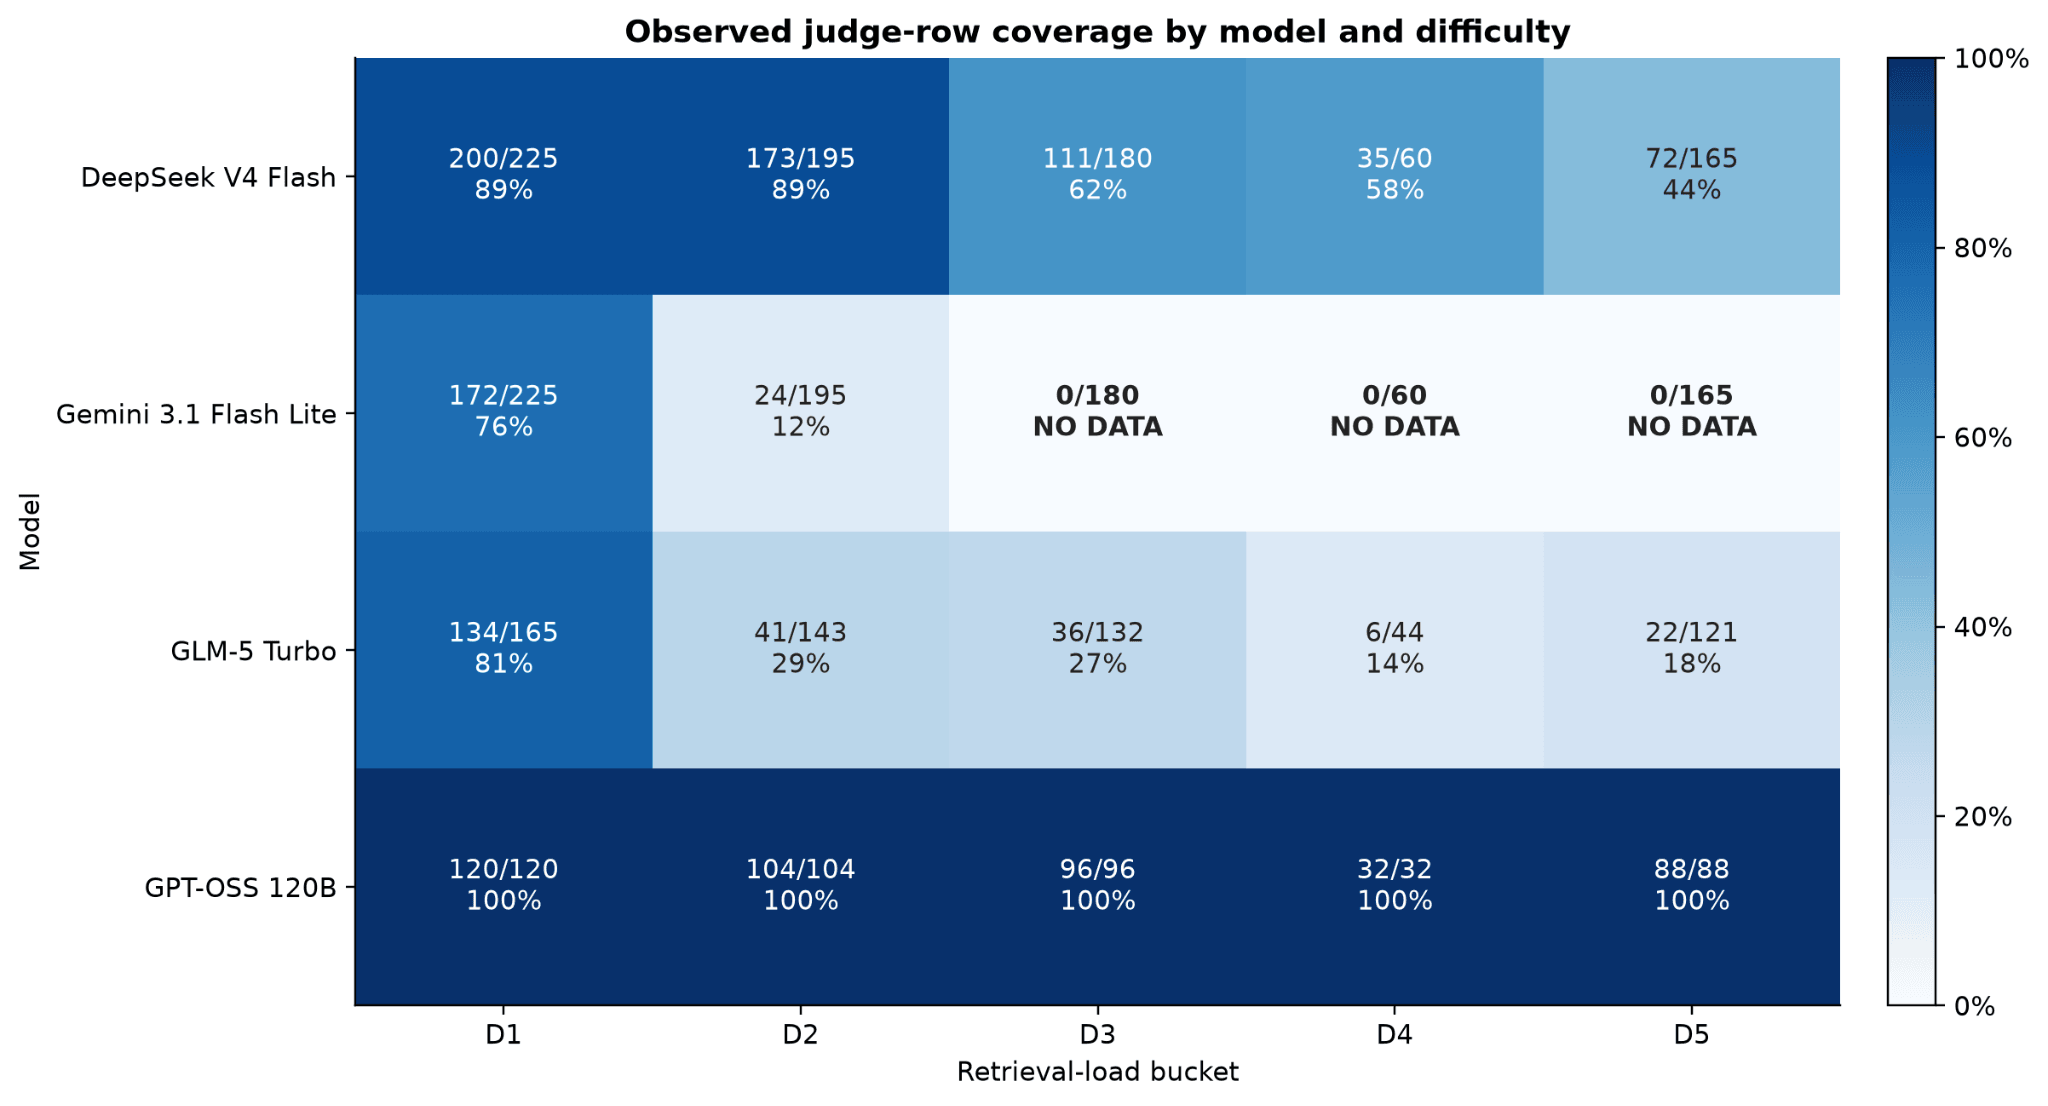
GLM과 Gemini는 NQ·정답 문서 한 개 조건에 결과가 편중됐습니다. 그래서 네 모델의 전체 통과율을 한 순위표에 넣지 않고, DeepSeek과 GPT-OSS가 모두 판정된 동일 조건만 주 비교에 사용했습니다.
3. 형식과 정답을 함께 만족해야 통과했습니다
API 오류와 같은 케이스의 재시도를 정리한 뒤, 비어 있지 않은 재시도 응답이 있으면 이를 우선했습니다. 오류 없이 반환된 빈 응답은 실패로 남겼습니다. 아래 통과율의 분모는 이 정제를 거친 평가 대상입니다.
보관된 LLM Judge는 응답 전체가 JSON 객체 하나인지, 최상위 키가 document_ids 하나인지, 정답 ID를 누락·추가·중복 없이 포함했는지를 함께 판정했습니다. 배열 순서는 허용했지만 코드 펜스나 설명이 붙거나 ID 문자열이 바뀌면 실패로 처리했습니다.
| 조건 | 응답에서 확인한 현상 | 실패한 기준 |
|---|---|---|
| NQ · 64K · GPT-OSS | 필요한 ID를 언급했지만 자연어로 답했습니다. | JSON-only 출력 형식 |
| HotpotQA · 32K | JSON 구조를 지켰지만 빈 배열을 반환했습니다. | 정답 문서 회수 |
따라서 측정값은 출력 형식 준수와 정답 문서 회수를 합친 복합 통과율입니다. 모든 실패를 최초 지시의 망각으로 해석할 수는 없습니다. Judge 모델·버전과 반복 판정의 일치도는 보관된 자료만으로 충분히 확인하지 못했습니다.
4. 같은 278개 조건에서 길이별 결과를 비교했습니다
한 케이스는 질문·정답 문서·distractor history·입력 길이가 같은 조건입니다. 두 모델이 모두 판정된 paired 278건을 비교했습니다. 같은 질문 family를 여러 길이에서 관측했으므로 278개의 독립된 질문을 뜻하지 않습니다.
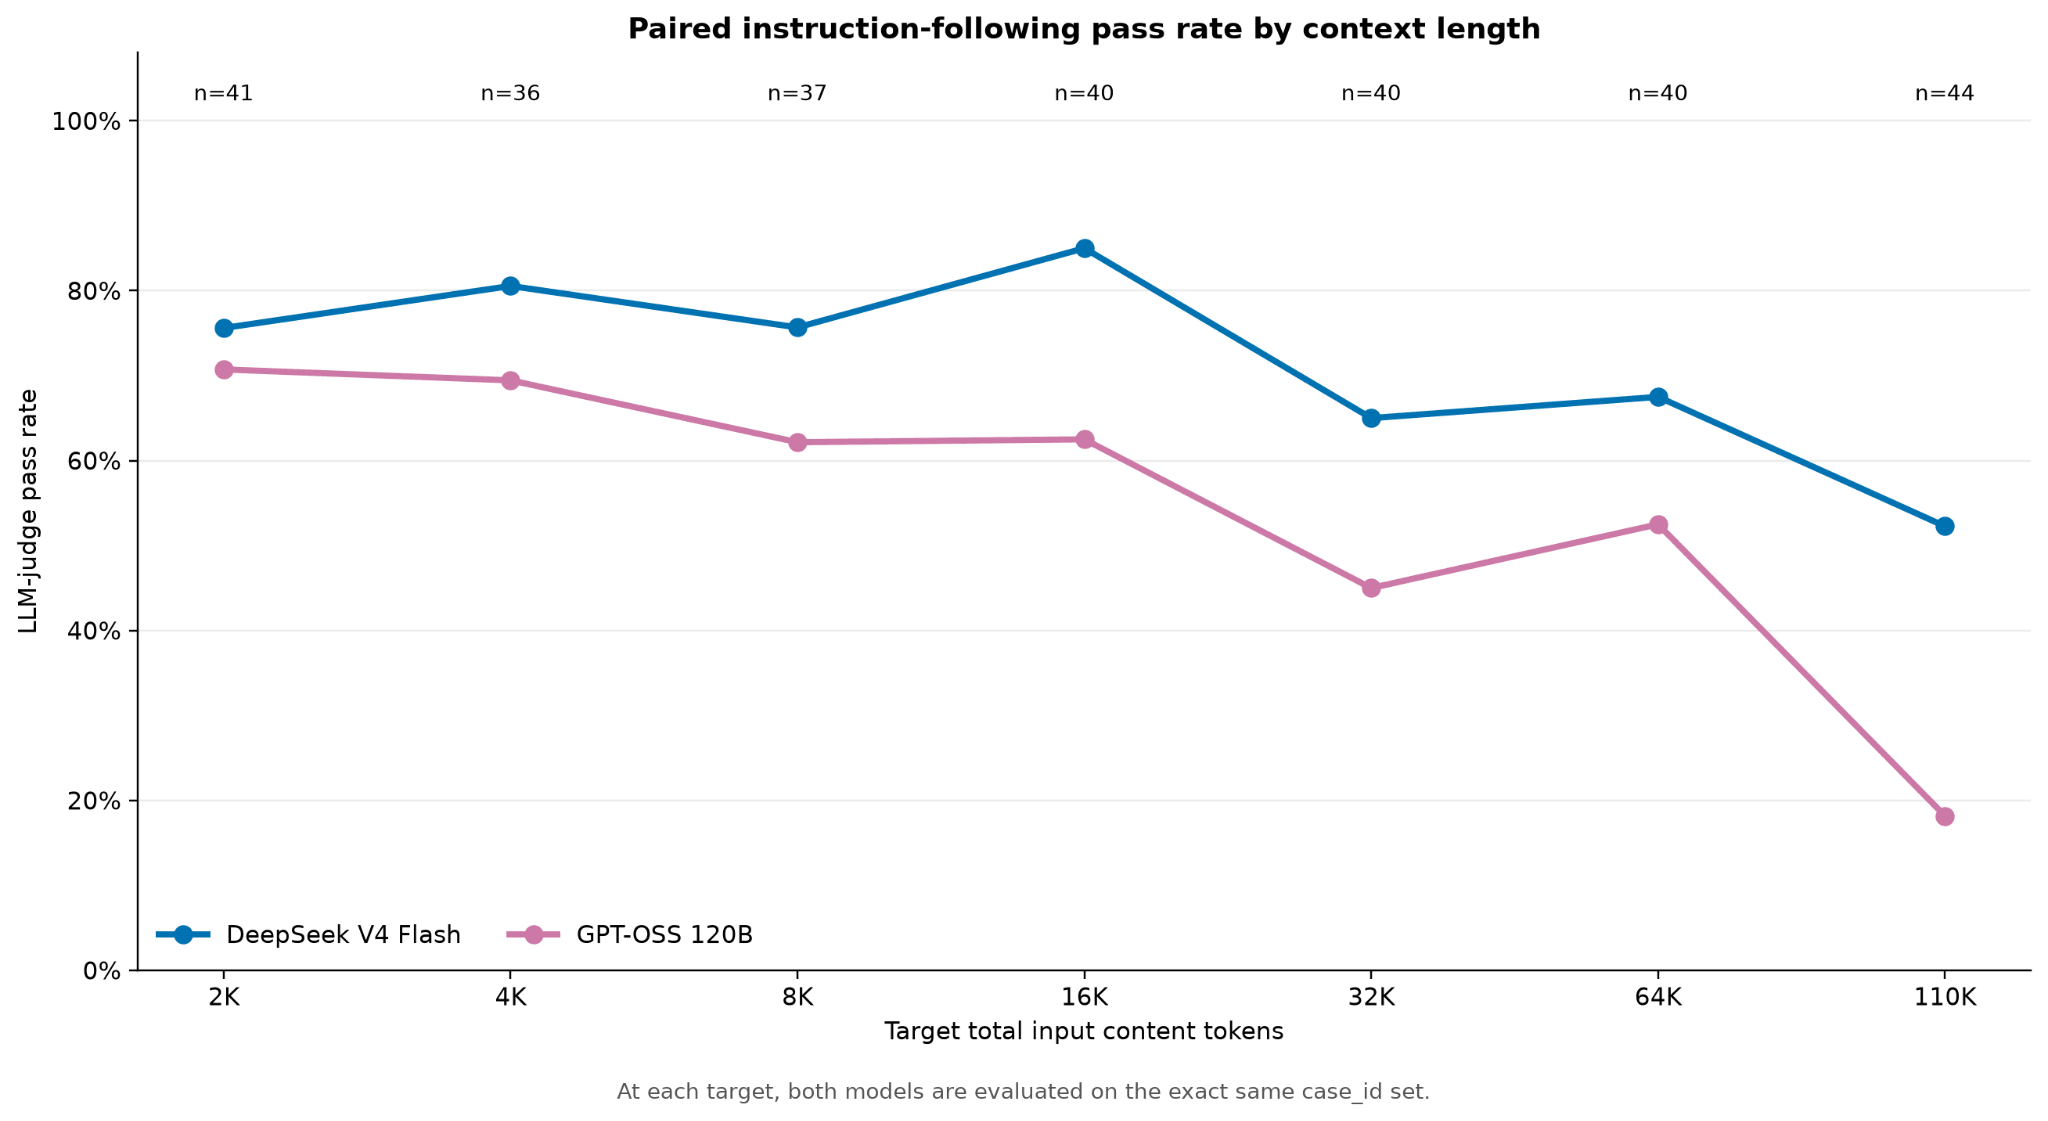
| 입력 목표 | paired n | DeepSeek V4 Flash | GPT-OSS 120B |
|---|---|---|---|
| 2K | 41 | 31/41 · 75.6% | 29/41 · 70.7% |
| 4K | 36 | 29/36 · 80.6% | 25/36 · 69.4% |
| 8K | 37 | 28/37 · 75.7% | 23/37 · 62.2% |
| 16K | 40 | 34/40 · 85.0% | 25/40 · 62.5% |
| 32K | 40 | 26/40 · 65.0% | 18/40 · 45.0% |
| 64K | 40 | 27/40 · 67.5% | 21/40 · 52.5% |
| 110K | 44 | 23/44 · 52.3% | 8/44 · 18.2% |
16K에서 32K로 갈 때 DeepSeek은 85.0%에서 65.0%, GPT-OSS는 62.5%에서 45.0%로 내려갔습니다. 길이별 완료 질문 구성이 다른 영향을 줄이려고 두 길이에 모두 있는 동일 family 33개만 다시 비교해도, DeepSeek은 30/33→25/33, GPT-OSS는 21/33→17/33으로 하락했습니다.
전체 곡선은 64K에서 일부 반등했습니다. 길이가 늘 때마다 일정하게 나빠진 패턴은 아니었으며, 110K에서는 특히 GPT-OSS의 통과율이 8/44로 낮았습니다.
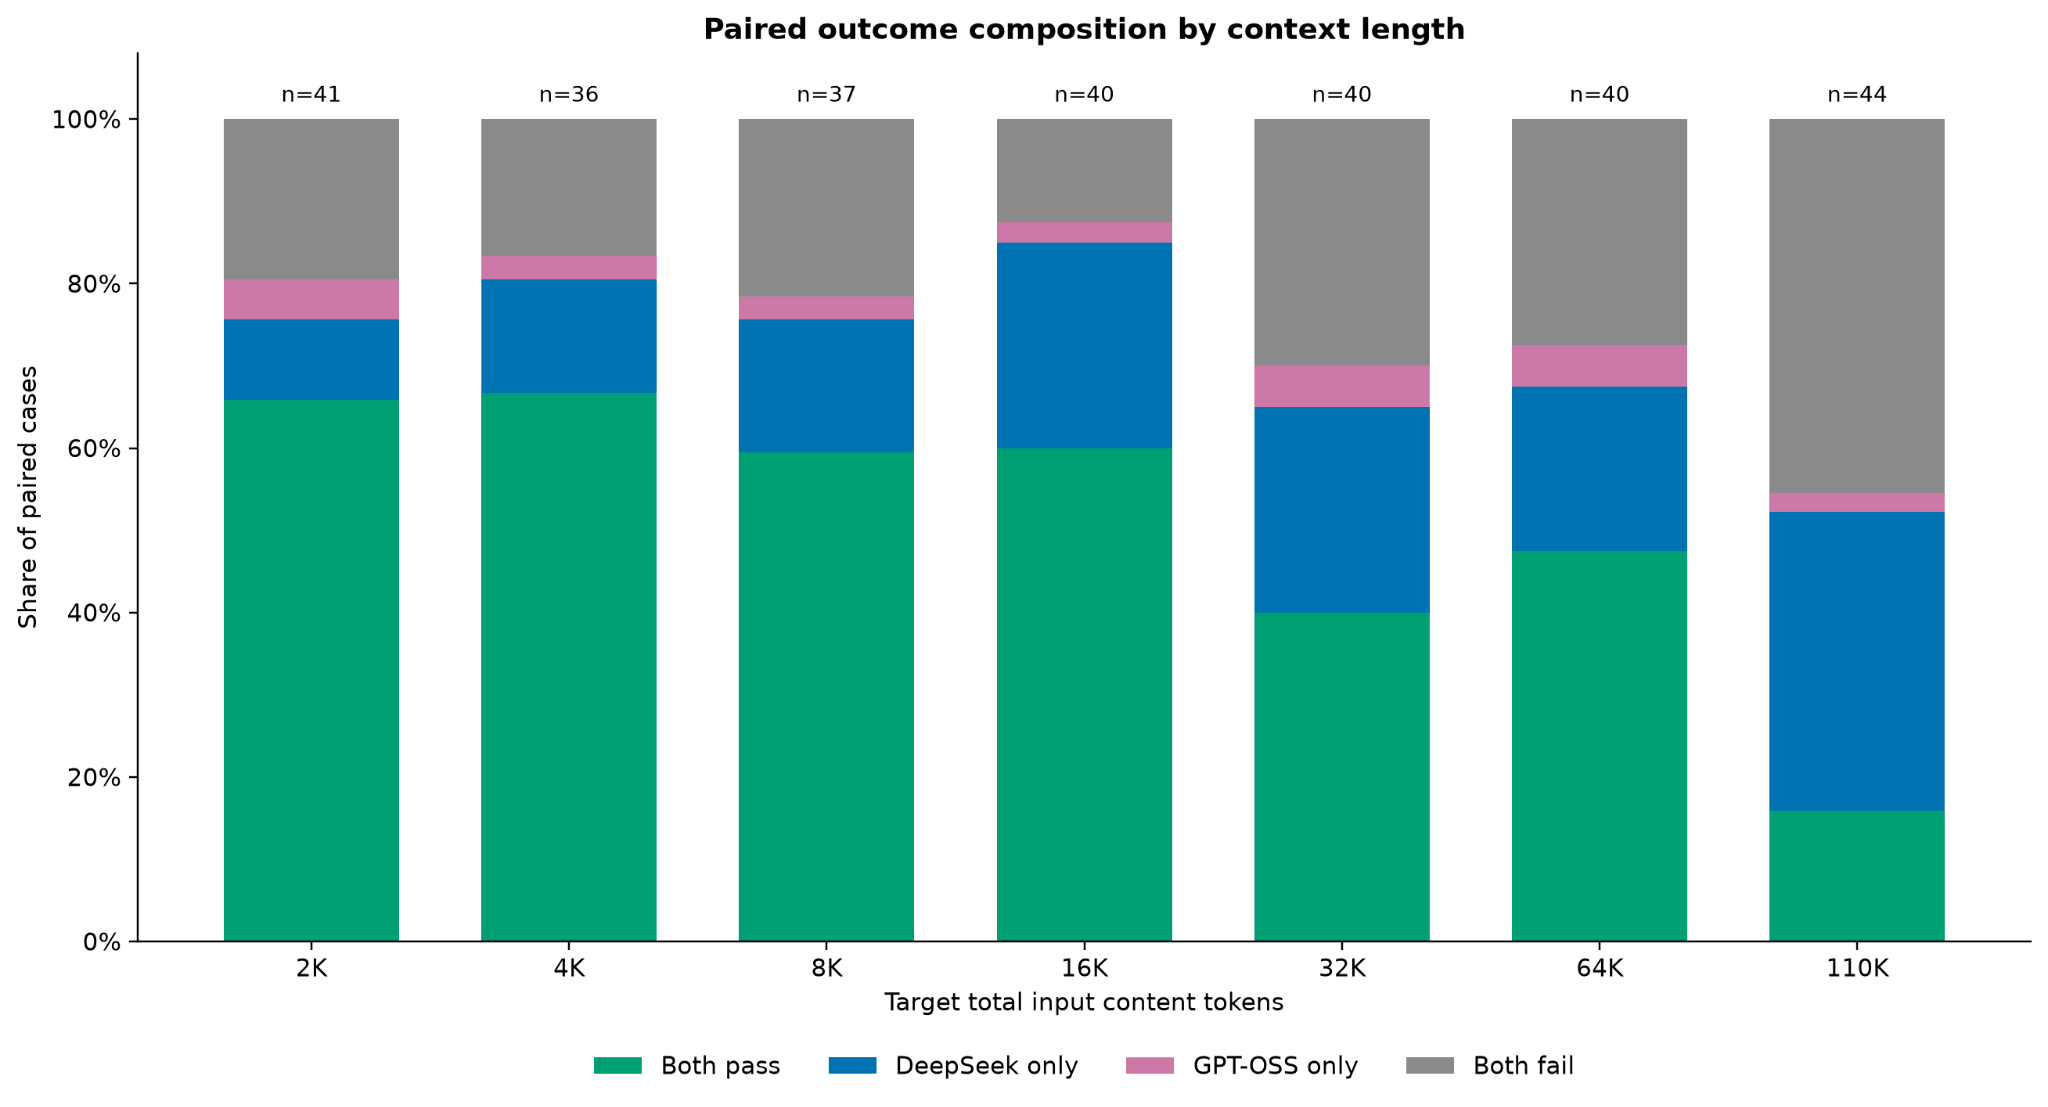
모델별 평균 뒤에는 공통 실패와 서로 다른 성공 사례가 있었습니다. 110K에서는 두 모델이 함께 통과한 조건이 7/44, 함께 실패한 조건이 20/44였습니다.
5. 최대 입력 길이와 대화 예산을 구분했습니다
두 모델이 함께 하락한 32K를 압축·맥락 재구성의 보수적인 개입 경계로 제안했습니다. 최대 context window를 그대로 채우기보다, 그 전에 중요한 지시와 기억을 다시 구성하는 방향입니다. 측정점이 16K 다음 32K이므로 정확한 개입 시점과 다른 모델에 적용할 예산은 추가 비교가 필요합니다.
이 실험의 history는 일상·관계 대화가 아닌 retrieval corpus였습니다. 말투·태도·서사의 일관성은 별도 대화 시나리오와 사람 평가로 확인할 과제입니다. 이번 결과는 첫 지시를 둔 입력을 어느 길이까지 사용할지 판단하는 근거로 남겼습니다.
제한된 입력에서 필요한 이야기를 이어 가려면 무엇을 남길지도 정해야 합니다. 다음 기억 설계 글에서는 원본 대화·최근 턴·요약·검색을 연결하고, 기억 실험 글에서는 압축으로 빠진 정보를 검색이 보완한 범위를 살펴봅니다.